Как закрыть сайт, раздел или страницу от индексации и от AI-краулеров

robots.txt управляет обходом сайта, но не гарантирует, что страница исчезнет из поиска. За удаление из индекса отвечают meta robots noindex и заголовок X-Robots-Tag. Сначала решите, что вам нужно: ограничить обход, убрать страницу из выдачи или закрыть контент от AI-краулеров. Механизм зависит от задачи.
Все разделы статьиОткрыть содержание
Разбираем по шагам четыре сценария закрытия и главную развилку: что реально убирает страницу из поиска, а что лишь ограничивает обход.
Создано · Обновлено
Для всего этого вам понадобится доступ к файлам сайта, к коду шаблонов или к настройкам хостинга и CDN. Если такого доступа нет, часть способов придётся отдать разработчику. А дальше по порядку, от простого сценария к тонкому.
Закрыть весь сайт директивой Disallow и когда это уместно
Сайт ещё на разработке или живёт на стейджинге? Тогда его рано показывать поиску.
Закрывать весь сайт от обхода уместно именно в этот период, пока страницы пустые или наполнены наполовину. Иначе поисковик успеет собрать сырые страницы и запомнит сайт как мусорный.
Для этого в robots.txt заводят одну общую группу.
User-agent: *
Disallow: /Такая запись закрывает обход всего сайта для соблюдающих её краулеров.
Но сам по себе Disallow: / не гарантирует, что страниц не будет в индексе. Он просит бота не ходить по сайту, а не удаляет уже известные адреса из поиска. Если на страницу кто-то ссылается снаружи, она может всплыть в выдаче, даже пока вы её прячете.
Чтобы на время разработки сайта действительно не было в индексе, нужен noindex на самих страницах, а не только строка в robots.txt. noindex прямо говорит поисковику убрать страницу из результатов, и это работает надёжнее запрета обхода.
Нельзя просто включить оба правила сразу.
Если вы одновременно закроете сайт в robots.txt и пропишете noindex на страницах, эти два правила подерутся. Закрытую в robots.txt страницу краулер не обойдёт, а значит, и правило noindex в её коде он никогда не прочитает. Выходит, индексацию вы запретили как будто дважды, но надёжнее не стало.
Под конкретную задачу работает что-то одно: либо закрываете обход через Disallow, либо убираете из индекса через noindex на открытой для обхода странице.
Опция WordPress в разделе Чтение
На WordPress этот выбор уже сделан за вас, и это удобно.
В разделе Настройки и дальше Чтение есть опция попросить поисковые системы не индексировать сайт. Она добавляет на страницы именно noindex, а не строку в robots.txt. То есть встроенная настройка делает правильную вещь для периода разработки.
Рядом часто включают режим обслуживания. Это сопутствующий приём: плагин закрывает сайт заглушкой от посетителей и обычно отдаёт код 503. Для поиска он noindex не заменяет, но помогает, пока сайт не готов к показу.
Для сайта на разработке берите noindex, а Disallow оставьте для управления обходом. Сам robots.txt при этом правят через файловый менеджер хостинга или из админки, если CMS это позволяет.
Закрыть раздел или отдельную страницу
Иногда закрывать весь сайт не нужно. Задача уже, например один раздел или одна страница.
Для этого в robots.txt добавляют точечный Disallow с путём без домена. Он закрывает обход указанного адреса или целого раздела, а остальной сайт остаётся открытым.
User-agent: *
Disallow: /cart/
Disallow: /catalog/filter/Править этот файл удобнее всего через файловый менеджер хостинга или панель управления: открыли robots.txt, дописали строку, сохранили.
Чаще всего точечным Disallow закрывают служебные URL: корзину, страницы фильтров, результаты внутреннего поиска. Это нужно, чтобы бот не тратил силы на бесполезные для выдачи адреса.
Если страница должна именно выпасть из индекса, а не просто перестать обходиться, Disallow вам не поможет. Тут нужен noindex: только он убирает страницу из результатов поиска. Disallow экономит краулинговый бюджет, но из выдачи ничего не вычищает.
Одна страница плагином или через Disallow
Это, кстати, живой вопрос из обсуждений: как закрыть от индексации одну-единственную страницу, плагином или строкой в robots.txt?
Ответ зависит от цели, потому что это разные механизмы. Закрытие на уровне страницы, например через SEO-плагин в настройках записи, задаёт странице noindex. А точечный Disallow в robots.txt закрывает только её обход. В популярном Yoast SEO, например, это делается во вкладке Дополнительно, где у записи выбирают вариант не показывать в результатах поиска.
Отсюда и правило выбора. Нужно убрать страницу из индекса, берите noindex на уровне страницы. Нужно закрыть обход служебного адреса ради краулингового бюджета, берите Disallow.
Хороший пример это раздел фильтров интернет-магазина. Таких URL бывают тысячи, и обходить их все поисковику незачем. Закрываете раздел фильтров в robots.txt, чтобы бот не расходовал на них бюджет. Это задача про обход, а не про удаление из индекса.
Почему Disallow в robots.txt не гарантирует удаление из индекса
Самый частый и самый обидный случай: закрыли страницу в robots.txt, а она всё равно висит в выдаче.
Так происходит потому, что robots.txt запрещает обход, а не индексирование. Это два разных уровня, и файл отвечает только за первый.
Закрытая в robots.txt страница может оставаться в поиске, например если на неё ссылаются с других сайтов.
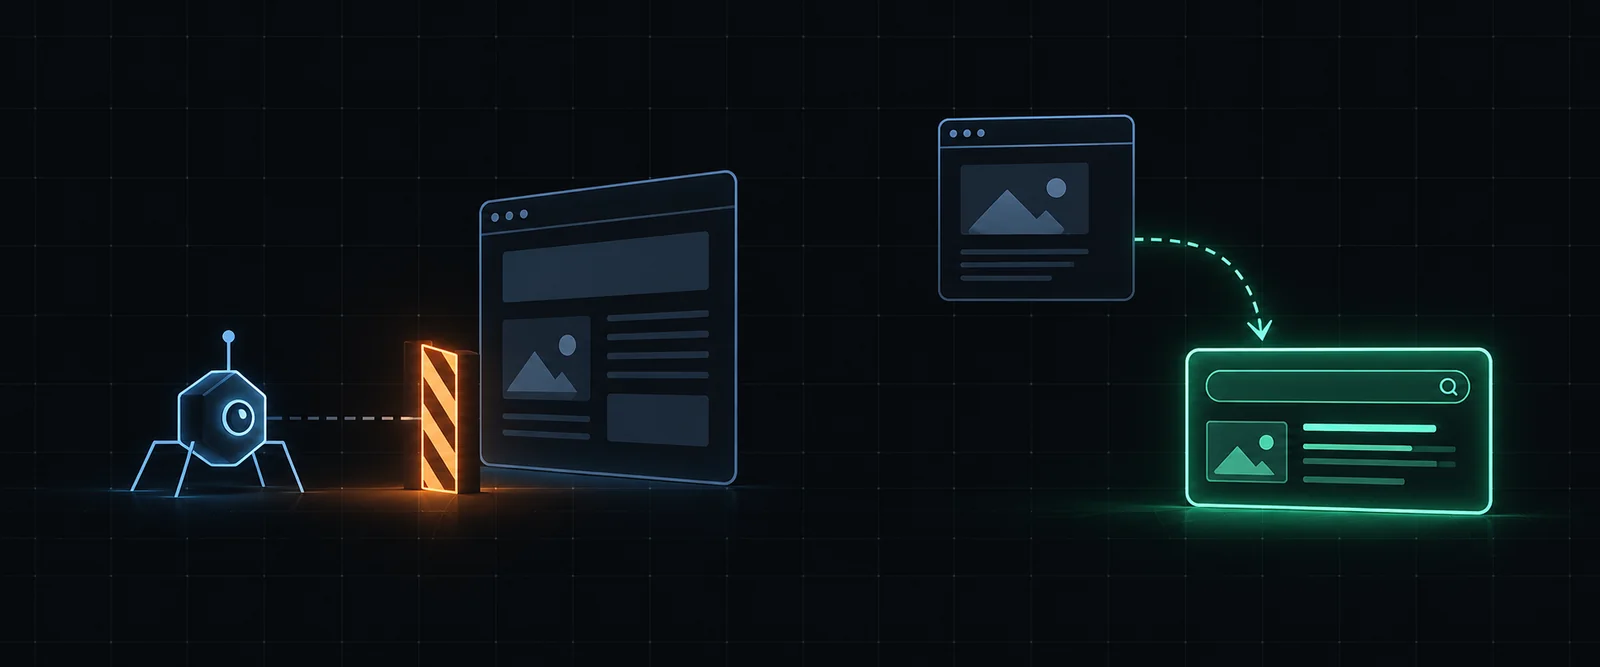
Пунктирная стрелка на схеме это внешняя ссылка: по ней поисковик узнаёт адрес со стороннего сайта и показывает его, хотя сам контент обойти не смог.
«If the page is blocked by a robots.txt file or the crawler can't access the page, the crawler will never see the noindex rule, and the page can still appear in search results, for example if other pages link to it.»Google Search Central, Block Search indexing with noindex, блок Important · проверено 20.10.2026
Что это значит для сайта. Одного Disallow мало, чтобы убрать страницу из поиска. Для этого нужен noindex на странице, которая открыта для обхода.
Поэтому запомните главное: robots.txt управляет обходом, а не деиндексацией.
| Механизм | Что делает | Условие и оговорка | Когда брать |
|---|---|---|---|
robots.txt Disallow | Просит соблюдающих ботов не обходить путь | Не гарантирует удаление из индекса, при внешних ссылках URL остаётся в поиске | Управление обходом и краулинговым бюджетом |
meta robots noindex | Убирает страницу из выдачи после обхода | Страница не должна быть закрыта в robots.txt, иначе правило не прочитают | HTML-страница, которую нужно убрать из индекса |
X-Robots-Tag | То же правило, но HTTP-заголовком | Удобно для не-HTML файлов и серверного уровня | PDF, изображения, нет доступа к коду страницы |
Парадокс noindex
Отсюда вытекает неочевидная вещь, на которой спотыкаются почти все.
Чтобы правило noindex сработало, страница НЕ должна быть закрыта в robots.txt. Если вы закроете её в файле, краулер просто не дойдёт до кода страницы и не увидит ваш noindex. Получается, одновременно закрыть страницу в robots.txt и ждать деиндексации по noindex невозможно, одно отменяет другое.
Звучит парадоксально, но логика прямая: чтобы бот выполнил просьбу уйти, он сначала должен эту просьбу прочитать.
Отсюда и порядок действий. Сначала открываете страницу для обхода, то есть убираете её из Disallow, и только потом ставите на неё noindex. Тогда бот зайдёт, прочитает правило и уберёт страницу из выдачи.
А как у Яндекса
У Яндекса логика та же, так что для русскоязычного сайта отдельных правил держать в голове не нужно.
Яндекс тоже предлагает закрыть обход через Disallow, а чтобы страница не попадала в поиск, использовать meta robots с директивой noindex или none. И то же предупреждение: если страница запрещена в robots.txt, но на неё ведут ссылки с других сайтов, она может попасть в результаты поиска. Об этом прямо сказано в справке Яндекс.Вебмастера о запрете индексации (проверено 20.10.2026).
Для RU-аудитории смысл один: правило «обход не равно индекс» действует и в Google, и в Яндексе.
Надёжное закрытие через meta robots noindex и заголовок X-Robots-Tag
Самый прямой способ для HTML-страницы это мета-тег robots со значением noindex в секции head. Когда Google обойдёт такую страницу и прочитает тег, он полностью уберёт её из результатов поиска, независимо от внешних ссылок. Это и описано в документации Google о блокировке индексации.
<meta name="robots" content="noindex">

X-Robots-Tag: noindexВот почему это надёжнее Disallow: тег прямо адресован поисковику и говорит про индекс, а не про обход.
Но есть обязательное условие, и оно вытекает из парадокса выше. Страница должна оставаться доступной краулеру, то есть не быть закрытой в robots.txt. Иначе бот не дойдёт до тега и правило не сработает. Открытость для обхода тут не досадная деталь, а часть решения.
Когда нужен X-Robots-Tag
Мета-тег живёт в HTML. А что делать с файлами, у которых head нет?
Для не-HTML файлов, например PDF или изображений, то же правило доставляют HTTP-заголовком X-Robots-Tag. Он же выручает, когда у вас нет доступа к коду страниц и удобнее настроить ответ на уровне сервера.
Важная деталь: заголовок эквивалентен мета-тегу по набору правил. Любое правило, которое можно записать в meta robots, доступно и как X-Robots-Tag. Это прямо сказано в спецификации Google по robots meta tag и X-Robots-Tag (проверено 20.10.2026).
Итого выбирайте по доступу. Есть доступ к шаблону страницы, ставьте мета-тег. Удобнее управлять ответами сервера или закрываете PDF, берите заголовок.
После установки достаточно коротко проверить, что тег или заголовок реально отдаётся на нужном URL. Подробный разбор проверки это тема соседнего материала хаба.
noindex и Disallow решают разные задачи и не заменяют друг друга.
Как закрыть сайт от AI-краулеров GPTBot, ClaudeBot, CCBot и Google-Extended
Не хотите, чтобы ваш контент уходил на обучение моделей? Тогда закрываем AI-краулеров.
Делается это теми же средствами robots.txt: для каждого бота заводят отдельную группу с его токеном и строкой Disallow. Тот же файл, что и для поисковых ботов, отдельная галочка для ИИ не нужна.
| Токен | Что контролирует | Ключевая оговорка |
|---|---|---|
GPTBot | Сбор контента для обучения моделей OpenAI | Настраивается независимо от поиска |
OAI-SearchBot | Показ сайта в поиске ChatGPT | Закрытие обучения не обязано закрывать поиск |
ClaudeBot | Сбор контента для обучения моделей Anthropic | Правило задают для каждого поддомена отдельно |
CCBot | Открытый сбор данных веба проектом Common Crawl | Встречаются краулеры, ложно представляющиеся CCBot |
Google-Extended | Использование контента для обучения моделей Gemini | Не влияет на показ и ранжирование в Google Поиске |
У OpenAI токенов два. GPTBot собирает контент для обучения, а OAI-SearchBot отвечает за показ сайта в поиске ChatGPT. По документации OpenAI о краулерах каждая настройка независима: можно разрешить поиск и при этом запретить использование контента для обучения. Там же публикуются диапазоны IP ботов.
То есть закрытие обучения не обязано закрывать поиск. Это разные цели, и решать их стоит отдельно.
ClaudeBot от Anthropic закрывается записью в robots.txt в корневом каталоге сайта, и такую запись по инструкции Anthropic делают для каждого поддомена отдельно. Там же отмечено, что блокировка по IP-адресам может не сработать надёжно, ведь она мешает боту прочитать сам robots.txt.
CCBot проекта Common Crawl закрывается аналогично, отдельной группой с Disallow: /.
Здесь важна оговорка от самого проекта. Common Crawl предупреждает, что встречаются краулеры, которые ложно представляются CCBot, и рекомендует проверять подлинность user-agent. Так что строка в файле закрывает настоящего бота, но не самозванцев.
Google-Extended стоит особняком. Это отдельный токен, которым вебмастер управляет использованием контента для обучения будущих моделей Gemini.
При этом, как указано в документации Google о краулерах, Google-Extended не влияет на включение сайта в Google Поиск и не является сигналом ранжирования. Закрыли его, значит отказались от обучения Gemini, но позиции в обычном поиске это не трогает.
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Google-Extended
Disallow: /Проверка на случайную блокировку
Иногда AI-ботов закрывают не специально. Правила приходят из шаблонов и старых конфигураций, а пресеты платформ вроде Cloudflare могут сами дописать в robots.txt сигнал не использовать контент для обучения ИИ.
Поэтому полезно просто открыть в браузере адрес вида yourdomain.com/robots.txt и поискать строки с GPTBot, ClaudeBot, Google-Extended и OAI-SearchBot. Увидели рядом Disallow, значит, этот краулер закрыт.
Зачем это важно. Случайная блокировка тихо режет AI-трафик и видимость контента в AI-ответах, а вы об этом даже не знаете, ведь правил руками не трогали. По оценке Ahrefs, около 5,9% из примерно 140 млн сайтов блокируют GPTBot, и далеко не всегда намеренно.
Применяют эти правила на нескольких уровнях: robots.txt, правила в .htaccess (перед правкой делайте бэкап) и файрвол или WAF. Полный разбор способов и проверку подлинности ботов оставим соседним материалам хаба.
Разбор ситуации из практики
Разбор ситуации
Пресет Cloudflare закрыл нужных ботов
На примере условной команды. При аудите сайта клиента обнаружилось, что GPTBot и ClaudeBot закрыты. Специально их никто не блокировал, сработал пресет Cloudflare, который так и не пересмотрели. После исправления настройки AI-реферальный трафик заметно изменился. Это наблюдаемая ситуация, а не обещанный результат для каждого сайта.
Редакция ZrokКлассический случай непреднамеренной блокировки. Начните с просмотра yourdomain.com/robots.txt и настроек управления ботами в панели платформы. Если блок не нужен, снимите его и перепроверьте доступ под каждого бота отдельно, по его токену.
Проверять robots.txt стоит не разово, а время от времени. Конфигурации меняются, платформы обновляют пресеты, и запись может появиться без вашего участия.
Почему часть AI-ботов может игнорировать запрет
Скажу честно: даже идеально написанный robots.txt это не замок.
«These rules are not a form of access authorization.»RFC 9309, Robots Exclusion Protocol, раздел 1 · проверено 20.10.2026
Что это значит для сайта. Протокол исключения роботов задаёт правила, которые краулеры соблюдают добровольно. Это просьба, а не технический барьер доступа.
Большинство авторитетных AI-компаний robots.txt соблюдает. Но часть скрейперов и ботов правила игнорирует, особенно те, кому незачем представляться честно. Это наблюдение практиков, а не гарантия: на добросовестных работает, на остальных нет.
Если доступ нужно закрыть жёстко, так, чтобы его нельзя было проигнорировать, запрет ставят на уровне сервера, CDN или WAF. Это, например, правила в .htaccess или ограничение частоты запросов. Такой барьер действительно способен полностью закрыть боту доступ к сайту.
Платой за надёжность становятся инженерные усилия. Серверный уровень требует больше работы и постоянного обслуживания, чем строка в robots.txt.
Уровни закрытия удобно собрать в одну развилку.
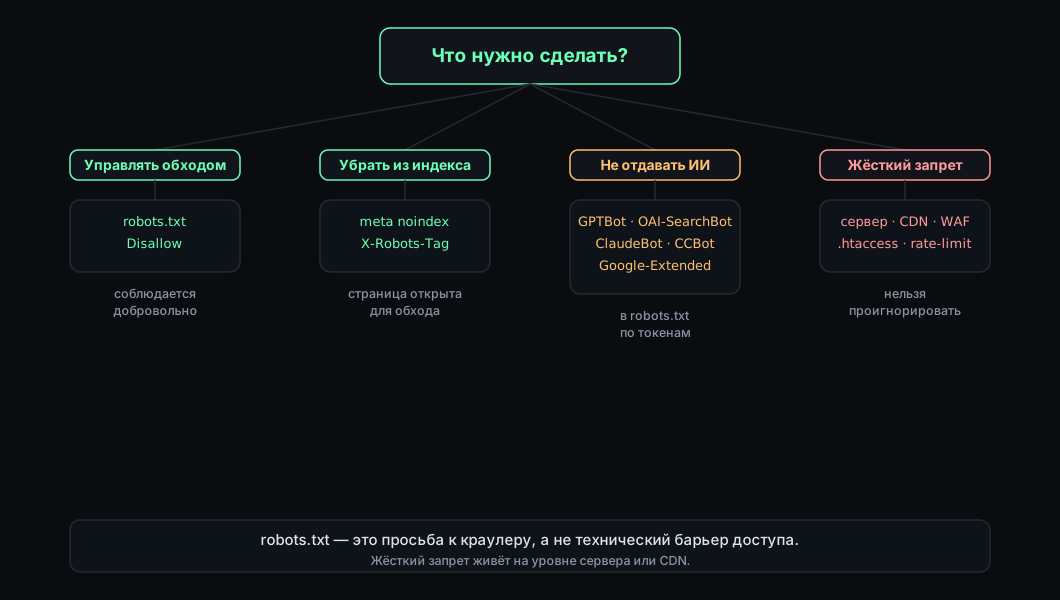
Разницу уровней удобно показать на Cloudflare. Он блокирует ботов на edge, то есть на подступах к сайту, и при этом сам файл robots.txt не редактирует.
Поэтому галочка в панели сервиса и запись в файле работают по-разному и не правят друг друга автоматически. Одно это технический барьер на трафике, другое это просьба в файле.
Что в итоге выбрать. Для добросовестных ботов достаточно сигнала в robots.txt, его они и так соблюдают. Для жёсткого закрытия от остальных нужен серверный или edge-уровень. Критерий простой: сопоставьте цену ошибки с трудозатратами. Если утечка контента к одному скрейперу некритична, хватит robots.txt. Если доступ закрывать нужно наверняка, вкладывайтесь в серверный уровень.
Частые вопросы
Что надёжнее robots.txt, если нужно убрать страницу из индекса?
Надёжнее meta robots noindex или заголовок X-Robots-Tag. При этом страница не должна быть закрыта в robots.txt, иначе краулер не дойдёт до правила и не прочитает его. Disallow управляет только обходом и из индекса ничего не убирает.
Навредит ли блокировка AI-ботов поисковому SEO?
В целом нет. Вы закрываете известные AI-боты, а обычный Google Search к AI-ботам не относится. Отдельно это подтверждает и Google-Extended: он управляет обучением Gemini и не влияет на показ и ранжирование в Google Поиске.
Почему закрытая в robots.txt страница всё равно в поиске?
Потому что Disallow запрещает обход, а не индексирование. Если на страницу ссылаются с других сайтов, её адрес может остаться в выдаче. Чтобы страница выпала из индекса, нужен noindex на открытой для обхода странице.
Насколько реально работает Disallow для AI-ботов?
Соблюдение добровольное, то есть на усмотрение самой системы. Авторитетные вендоры правило уважают, но часть ботов его игнорирует. Если нужно закрыть доступ наверняка, надёжнее серверный уровень, например правила в .htaccess.