Что такое CCBot, как он выглядит в логах и как управлять его доступом

Коротко: CCBot — это официальный краулер некоммерческого фонда Common Crawl. Он собирает открытые страницы в бесплатный архив веба, которым пользуются десятки исследовательских и коммерческих команд. Сам CCBot не обучает модели, но его данные часто берут как обучающие. Он представляется строкой User-Agent со словом «CCBot» и подчиняется robots.txt.
Все разделы статьиОткрыть содержание
CCBot — это краулер некоммерческого проекта Common Crawl, который обходит открытые страницы и складывает их в общедоступный архив веба. Если вы заметили его в логах и не знаете, оставить доступ или закрыть, ниже разобраны главные вопросы: что это за бот, как он связан с обучением AI-моделей, как выглядит его строка в логах, как отличить настоящего бота от подделки и как разрешить или запретить ему заходить через robots.txt.
Создано · Обновлено
Что такое CCBot и при чём здесь Common Crawl
Прежде чем решать, что делать с ботом, полезно увидеть всю цепочку целиком: кто собирает страницы, куда они попадают и кто ими потом пользуется.
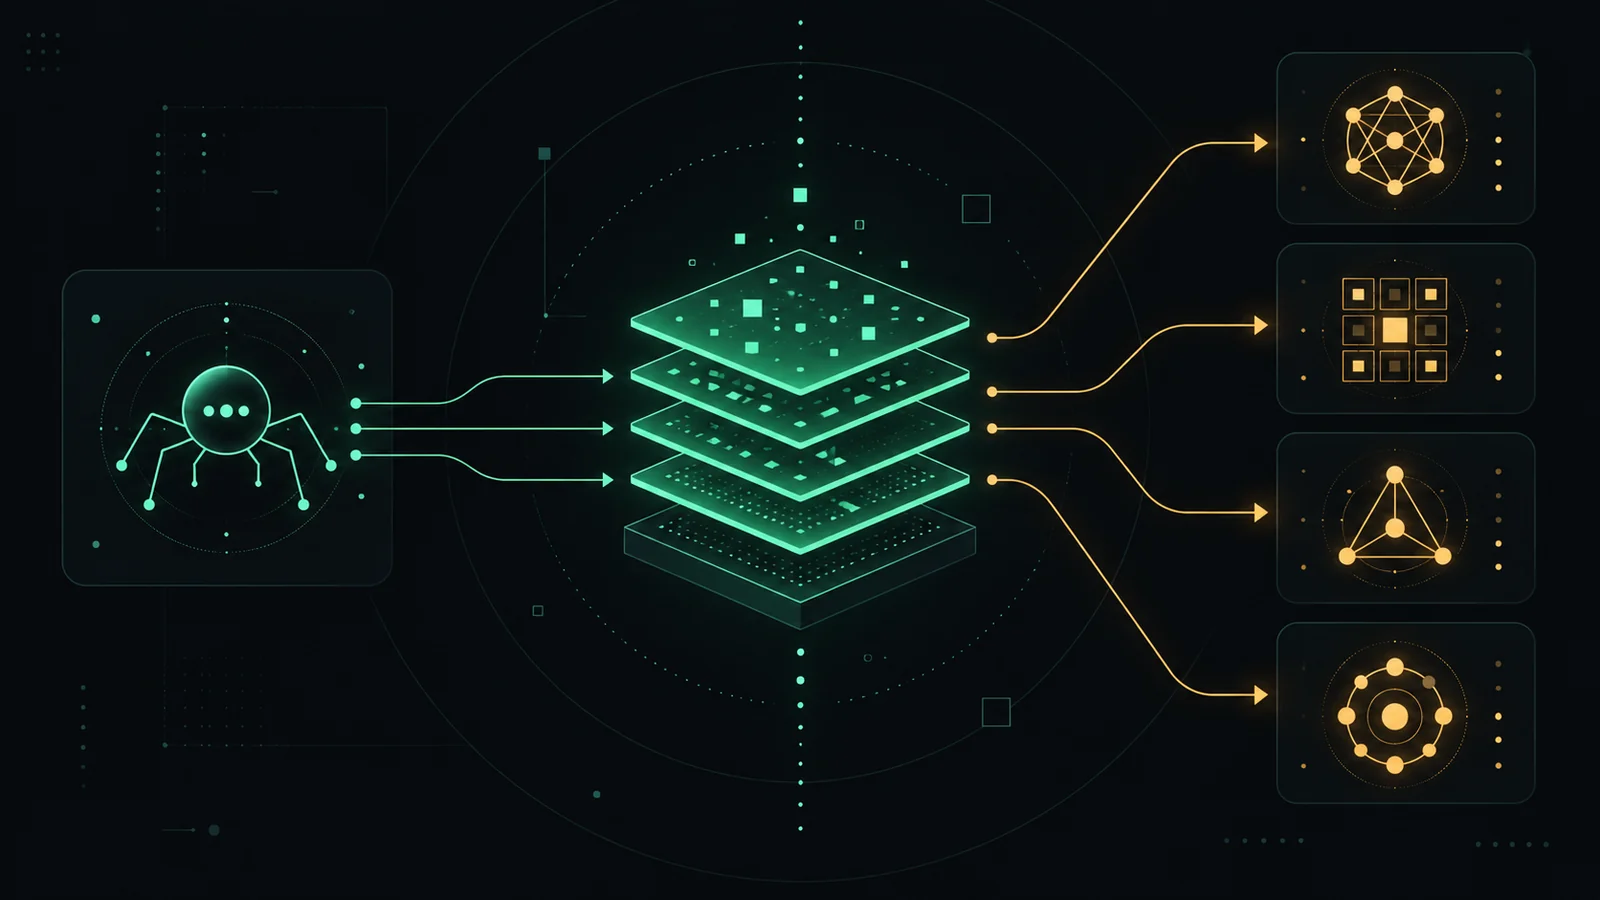
CCBot запускает Common Crawl — некоммерческий фонд со статусом 501(c)(3). Его задача не поиск и не продажа данных, а копия открытого веба, доступная любому бесплатно для исследований и анализа. CCBot обходит общедоступные страницы, а результат складывается в большой открытый архив, который Common Crawl выкладывает в открытых форматах и хранит на Amazon S3.
Важно сразу развести два понятия. CCBot — это краулер, то есть программа, которая ходит по сайтам и забирает страницы. Поисковым роботом он при этом не является: Common Crawl не строит поисковую выдачу и не присылает к вам читателей. Он просто пополняет архив, а дальше этот архив скачивают и используют сторонние команды.
По технике CCBot ведёт себя аккуратно. Он сначала читает robots.txt и только потом запрашивает разрешённые страницы, поддерживает HTTP/1.1 и HTTP/2, не исполняет JavaScript и не использует cookies. Если сервер отвечает ошибками 429 или 5xx, краулер сам замедляется — у него есть алгоритм снижения нагрузки.
«Common Crawl is a 501(c)(3) non-profit organization dedicated to providing a copy of the Internet to Internet researchers, companies and individuals at no cost for the purpose of research and analysis.»Common Crawl FAQ · раздел What is Common Crawl · проверено 19.10.2026
Что это значит для сайта: к вам приходит бот не поисковика и не одной AI-компании, а независимого архива, поэтому решение о доступе касается всех, кто потом возьмёт этот архив.
Как данные Common Crawl попадают в обучение AI-моделей
CCBot сам не обучает никакие модели. Он только наполняет архив. Но именно архив Common Crawl давно стал одним из самых удобных источников текстов для машинного обучения: он большой, открытый и бесплатный, поэтому команды, которым нужны обучающие данные, берут готовую копию веба вместо того, чтобы обходить сайты самостоятельно.
Отсюда вытекает неочевидное следствие. Когда вы закрываете CCBot, вы влияете не на одну конкретную модель, а на всех, кто обучается на архиве Common Crawl. Это и сильная, и слабая сторона решения: одной настройкой вы отказываетесь от попадания в общий датасет сразу у многих, но и не управляете каждым отдельным проектом, который мог скачать архив раньше.
Стоит помнить и о масштабе. Common Crawl берёт не весь сайт целиком, а случайную выборку страниц, поэтому в архив попадает лишь часть ваших материалов, а не точная копия всего сайта.
Гарантий в обе стороны здесь нет. Открытый доступ для CCBot не означает, что ваш сайт обязательно окажется в ответах какой-то AI-системы, а запрет не стирает то, что уже попало в прежние выпуски архива. Разумнее относиться к настройке как к выбору на будущее: участвовать ли вашим текстам в общем обучающем наборе дальше.
User-Agent CCBot в логах
В access-логе CCBot видно по строке User-Agent. В ней есть имя бота и ссылка на страницу Common Crawl, которая его описывает. Вот актуальная строка и целая запись лога, в которой бот запросил страницу.
CCBot/2.0 (https://commoncrawl.org/faq/)18.97.14.84 - - [19/Oct/2026:09:12:45 +0000] "GET /blog/chto-takoe-ccbot HTTP/1.1" 200 15233 "-" "CCBot/2.0"Обратите внимание на номер версии. Сейчас в документации указан CCBot/2.0, но у прежнего бота строка была другой — CCBot/1.0 (+https://commoncrawl.org/bot.html), и Common Crawl прямо предупреждает, что номер версии со временем может вырасти. Поэтому в фильтрах опирайтесь на имя «CCBot», а не на строку целиком, иначе обновление бота однажды обойдёт вашу настройку.
Как проверить, что визит настоящий
Строку User-Agent может выставить кто угодно. Common Crawl отдельно отмечает, что встречаются краулеры, которые ложно называются CCBot, поэтому само имя в логе ничего не доказывает. Надёжнее проверять по адресу запроса. CCBot ходит с выделенных диапазонов IP с обратным DNS: адрес настоящего бота разворачивается в имя вида 18-97-14-84.crawl.commoncrawl.org. Актуальные диапазоны v4 и v6 Common Crawl публикует отдельным файлом по адресу index.commoncrawl.org/ccbot.json.
Поэтому полезно держать в голове разницу между проверенным и поддельным визитом.
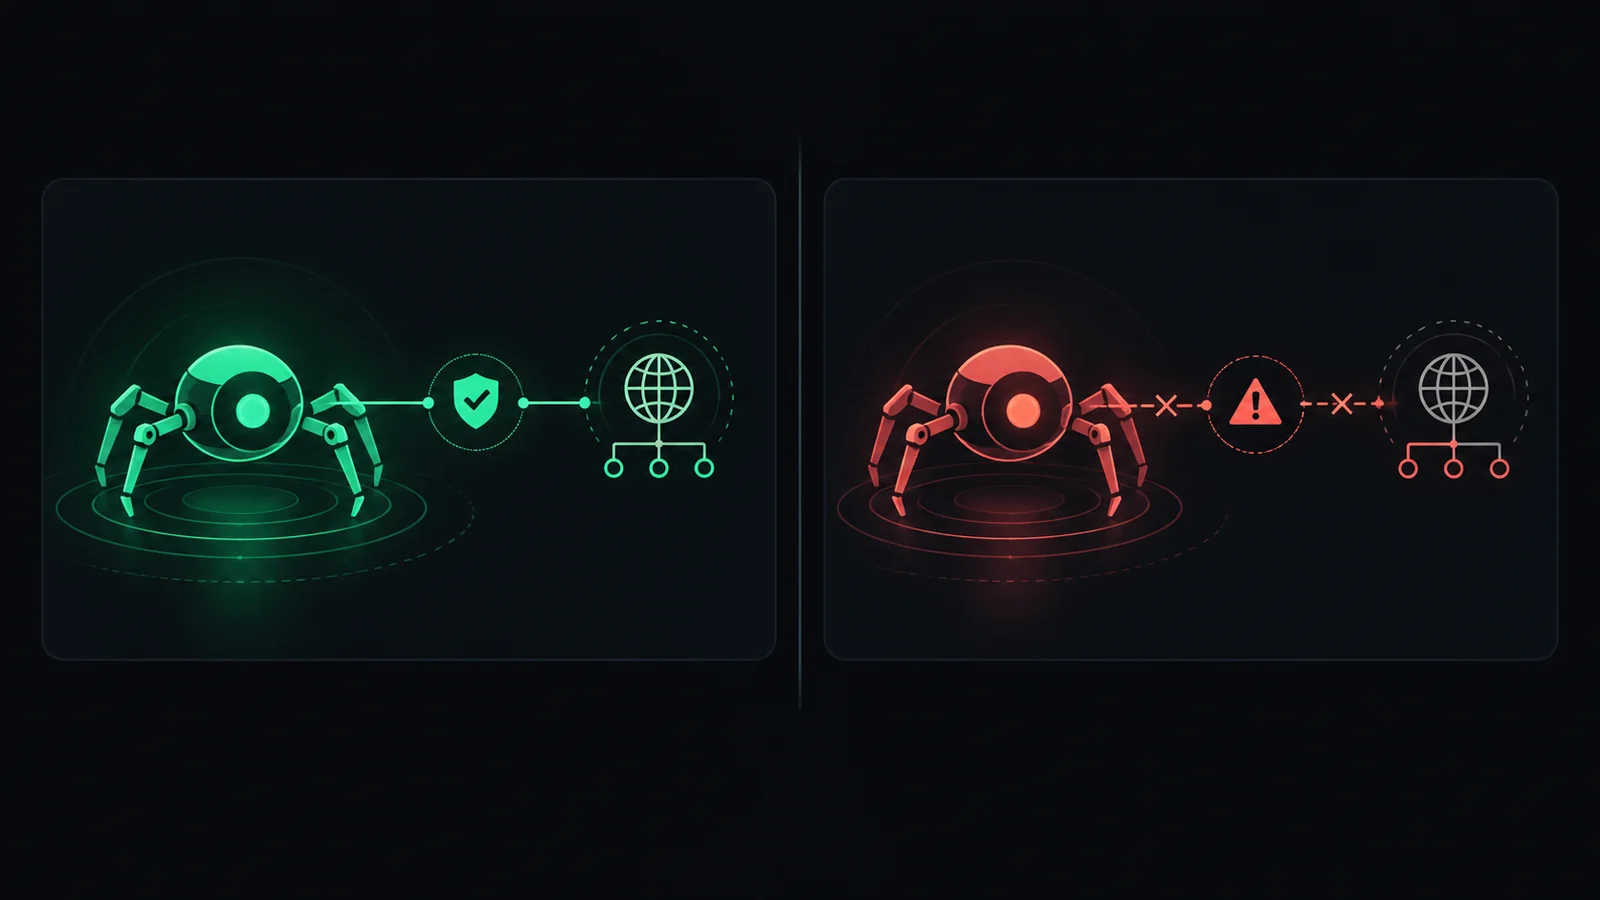
Это тот же принцип, по которому проверяют как проверить подлинность краулера вообще: имя заявляется в User-Agent, а подлинность подтверждается обратным DNS и совпадением IP с опубликованным списком — так же, как для любого бота. Доверяйте адресу запроса, а не подписи в логе.
Как разрешить или заблокировать CCBot в robots.txt
Управление доступом CCBot живёт в файле robots.txt в корне сайта. Правила задаются группами: строка User-agent с именем бота и под ней директивы. Если группы для CCBot нет и нигде не стоит запрет, доступ открыт по умолчанию — бот обойдёт сайт. Чтобы закрыть его полностью, добавьте отдельную группу с именем бота и запретите весь сайт.
User-agent: CCBot
Disallow: /Полностью закрывать доступ нужно не всегда. Common Crawl понимает параметр Crawl-delay и замедляет обход, если вы увеличите это число. Так можно оставить сайт в архиве, но снизить частоту запросов — это полезно, когда вас смущает нагрузка, а не сам факт сбора.
User-agent: CCBot
Crawl-delay: 2Две детали часто упускают. Во-первых, запись User-agent: * — это правило для всех, но у именованных AI-краулеров есть собственные имена, и общий блок их не адресует: каждому такому боту нужна отдельная группа по имени. Во-вторых, robots.txt соблюдается добровольно. Common Crawl ему подчиняется, но технически файл никого не держит, поэтому против недобросовестных скраперов нужен барьер на уровне сервера, CDN или WAF, где трафик режется физически.
Учтите и то, что правки вступают в силу не мгновенно. Common Crawl периодически перечитывает robots.txt, поэтому новый запрет или Crawl-delay сработает при следующей проверке файла, а не в ту же секунду.
Дальше всё сводится к тому, что именно вас беспокоит — участие текстов в архиве или нагрузка на сервер. От этого и зависит, какую из дорожек вы оставите CCBot.
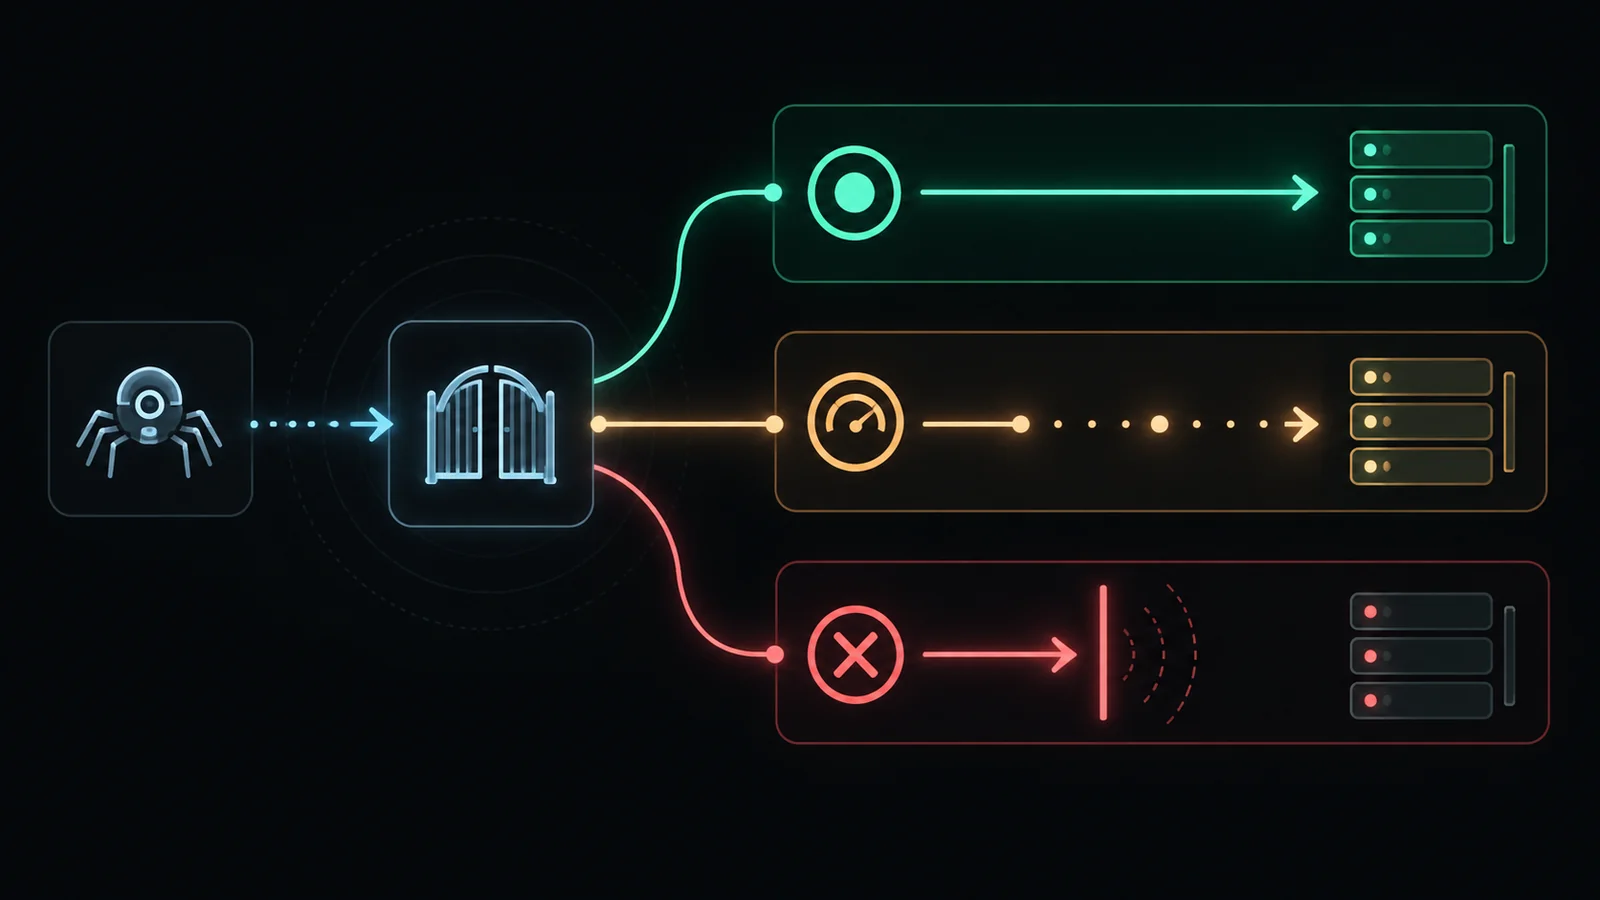
| Вариант | Что происходит | Когда подходит |
|---|---|---|
| Оставить доступ | Группы нет или стоит Allow. CCBot свободно обходит сайт. | Вы не против участия текстов в открытом архиве. |
| Замедлить (Crawl-delay) | Доступ остаётся, но запросы реже. | Беспокоит нагрузка на сервер, а не сам сбор. |
| Заблокировать | Disallow: / закрывает весь сайт для добросовестного бота. | Не хотите, чтобы тексты дальше шли в общий архив. |
Разбор ситуаций читателей
Задать вопросРазбор ситуации Стоит ли на всякий случай закрыть весь сайт целиком, если я вижу в логах CCBot и других AI-краулеров и не до конца понимаю, зачем они ходят.
Ответ редакции ZrokЗакрывать весь сайт «на всякий случай» обычно не стоит, особенно если вам важен трафик из AI-платформ. Полный запрет одной строкой задевает сразу всех ботов, а не только тех, кого вы хотели ограничить, и легко отрезать заодно полезные визиты. Разумнее закрывать выборочно: закройте служебные и приватные разделы, а для CCBot примите осознанное решение — оставить, замедлить через Crawl-delay или запретить именно его. А чтобы понять последствия, посмотрите по access-логу за несколько дней, кто реально перестал заходить после правки.
Короткие вопросы и ответы
Зачем вообще кого-то блокировать?
Частая причина — нежелание, чтобы оригинальный контент использовался AI-компаниями без вознаграждения. Это право владельца: решать, участвуют ли его тексты в общем обучающем наборе. robots.txt как раз и фиксирует этот выбор для добросовестных ботов. Бывают и практические поводы — лишняя нагрузка на сервер или защита уникальных материалов от переиспользования конкурентами.
Снизит ли блокировка CCBot нагрузку на сервер?
Если дело только в нагрузке, полный запрет не обязателен. CCBot обрабатывает параметр Crawl-delay и сам замедляется при ответах 429 или 5xx, так что частоту обхода можно просто уменьшить, оставив сайт в архиве. Блокировать имеет смысл, когда вопрос не в нагрузке, а в самом факте сбора.
CCBot принадлежит какой-то одной AI-компании?
Нет. CCBot — краулер независимого некоммерческого фонда Common Crawl, а не отдельного продукта. Его архив открыт и бесплатен, поэтому им пользуются многие команды сразу. Именно поэтому настройка доступа к CCBot влияет на весь круг тех, кто берёт этот архив.
Источники
- Common Crawl — CCBotСтрока User-Agent, директива блокировки в robots.txt, проверка подлинности по reverse DNS и выделенным диапазонам IP.
- Common Crawl — FAQНазначение фонда и открытого архива, поведение CCBot с robots.txt, обработка Crawl-delay и снижение нагрузки.
Источники проверены .