Что такое GPTBot, какой у него User-Agent и как управлять доступом

Коротко: GPTBot — это официальный обучающий краулер OpenAI. Он представляется строкой User-Agent со словом «GPTBot», ходит с опубликованных IP-адресов и подчиняется robots.txt. К поиску внутри ChatGPT он отношения не имеет — за выдачу отвечает отдельный бот OAI-SearchBot.
Все разделы статьиОткрыть содержание
GPTBot — это краулер OpenAI, который обходит сайты и собирает тексты для обучения моделей вроде ChatGPT. Если вы заметили его в логах и не знаете, радоваться визиту или закрывать доступ, ниже разобраны главные вопросы: кто его запускает, как он подписывается, как отличить настоящего бота от подделки и как разрешить или запретить ему заходить.
Создано · Обновлено
Что такое GPTBot и кто его запускает
GPTBot запускает OpenAI — та же компания, что делает ChatGPT. Это обучающий краулер: он обходит общедоступные страницы и забирает тексты, на которых потом дообучаются генеративные модели. В логах он ведёт себя как обычный поисковый робот: запрашивает страницы, читает HTML, идёт по ссылкам.
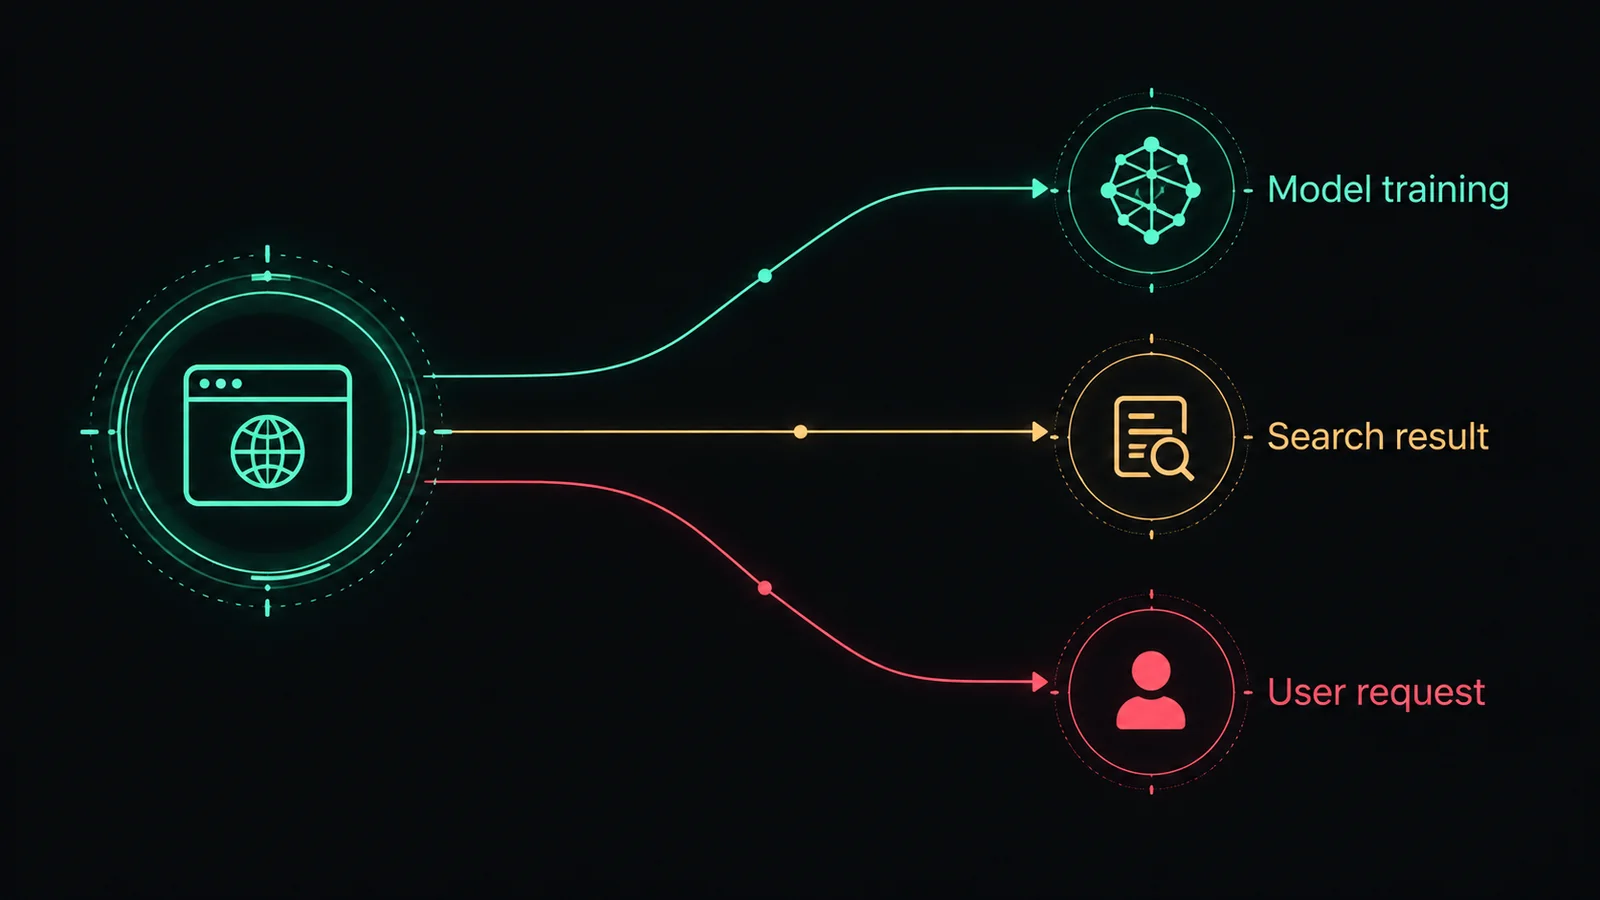
Главная путаница возникает из-за того, что у OpenAI не один бот, а три, и у каждого своя работа. Если закрыть не того, можно случайно исчезнуть из поиска ChatGPT, хотя хотели лишь отказаться от обучения.
| Бот | Что делает | Где опубликованы IP |
|---|---|---|
| GPTBot | Собирает контент для обучения моделей. | openai.com/gptbot.json |
| OAI-SearchBot | Показывает сайты в результатах поиска ChatGPT. | openai.com/searchbot.json |
| ChatGPT-User | Заходит на страницу по запросу пользователя в ChatGPT. | openai.com/chatgpt-user.json |
Запомните это разделение: правила для одного бота не распространяются на двух других. Именно поэтому OpenAI разрешает оставить открытым поиск и при этом закрыть обучение.
«GPTBot is used to make our generative AI foundation models more useful and safe.»OpenAI Crawlers documentation · раздел GPTBot · проверено 19.10.2026
Что это значит для сайта: GPTBot приходит ради обучающих данных, а за показ в ChatGPT и за переходы по запросу пользователя отвечают другие боты, которыми вы управляете отдельно.
Зачем GPTBot заходит на сайт и что происходит с контентом
Цель визита одна — собрать тексты для обучения моделей OpenAI. GPTBot не строит поисковый индекс и не присылает к вам читателей напрямую; он пополняет обучающую выборку. Поэтому владельцы контента чаще всего решают один вопрос: согласны ли они, чтобы их материалы участвовали в обучении.
Ответ на этот вопрос вы даёте через robots.txt. Запрет для GPTBot OpenAI трактует однозначно — как сигнал не использовать контент сайта в обучении базовых моделей. Это не блокировка «на всякий случай», а осмысленный выбор: отдавать тексты в обучение или нет.
«Disallowing GPTBot indicates a site's content should not be used in training generative AI foundation models.»OpenAI Crawlers documentation · раздел GPTBot · проверено 19.10.2026
Что это значит для сайта: если вы не хотите, чтобы тексты уходили в обучение, достаточно запретить GPTBot в robots.txt — и при этом можно оставить открытым OAI-SearchBot, чтобы сохранить видимость в поиске ChatGPT.
Решение зависит от того, что вам важнее. Новостным и платным проектам обучающий сбор часто не нужен, и они закрывают GPTBot. Тем, кто хочет, чтобы модели «знали» о продукте, визит полезен. Крайности редко оправданы: закрывать всё подряд опасно, потому что вместе с обучением можно отрезать и полезный трафик из AI-платформ.
Как выглядит User-Agent GPTBot в логах
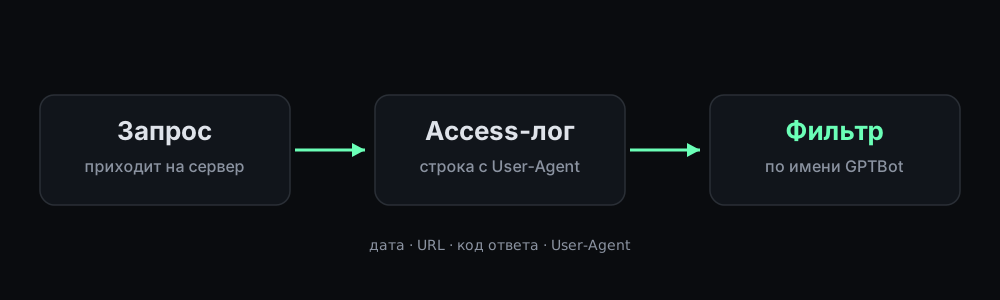
В access-логе GPTBot видно по строке User-Agent. В ней всегда есть само имя бота и ссылка на страницу OpenAI, которая его описывает. Вот как выглядит актуальная строка и целая запись лога, в которой бот запросил страницу.
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot203.0.113.42 - - [19/Oct/2026:08:14:22 +0000] "GET /blog/kak-rabotaet-gptbot HTTP/1.1" 200 18542 "-" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; …"Обратите внимание на номер версии. Сейчас в документации указан GPTBot/1.4, но в старых логах встречается и прежняя версия — например, один из владельцев сайтов замечал у себя GPTBot/1.2. Версия со временем меняется, поэтому в фильтрах и правилах опирайтесь на имя «GPTBot», а не на полную строку целиком, иначе обновление бота однажды обойдёт вашу настройку.
Как убедиться, что это настоящий GPTBot, а не подделка
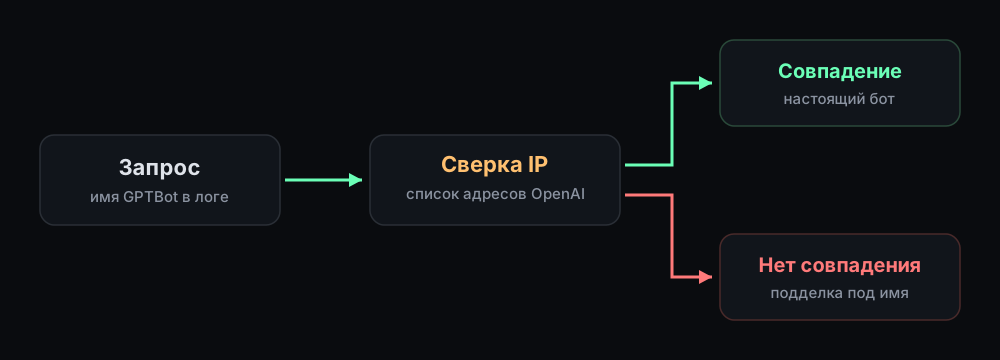
Строку User-Agent может выставить кто угодно. Любой скрипт или сканер вправе назваться «GPTBot», чтобы выглядеть безобидно или обойти простые фильтры. Поэтому само имя в логе ничего не доказывает — это лишь заявление, а не удостоверение.
Надёжный признак — IP-адрес, с которого пришёл запрос. OpenAI публикует актуальные диапазоны адресов GPTBot отдельным файлом, и настоящий бот ходит только из них. Сверьте IP из лога со списком по адресу openai.com/gptbot.json: если адрес в диапазонах — перед вами настоящий GPTBot, если нет — это подделка под его именем.
Это тот же принцип, по которому проверяют любого крупного краулера: имя заявляется в User-Agent, а подлинность подтверждается адресом запроса. Общий разбор метода и список других AI-ботов на сайте вынесены в обзор AI-ботов, здесь достаточно запомнить правило: доверять IP, а не подписи.
Как разрешить или ограничить GPTBot в robots.txt
Управление доступом GPTBot живёт в файле robots.txt в корне сайта. Правила задаются группами: строка User-agent с именем бота и под ней Disallow или Allow. Чтобы закрыть обучение полностью, добавьте отдельную группу для GPTBot и запретите весь сайт.
User-agent: GPTBot
Disallow: /Как оставить поиск и закрыть обучение
Поскольку поиск ChatGPT обслуживает отдельный бот, вы можете закрыть обучение, но остаться в выдаче. Для этого в одном файле держат две группы: запрет для GPTBot и разрешение для OAI-SearchBot.
User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /Такое разделение работает благодаря правилам сопоставления из стандарта robots.txt. Бот ищет свою группу по имени и подчиняется именно ей, а при нескольких подходящих строках выбирает наиболее точную — ту, в которой совпадение длиннее. Поэтому общий «User-agent: *» не управляет GPTBot, если у бота есть собственная группа.
«Crawlers MUST use case-insensitive matching to find the group that matches the product token and then obey the rules of the group.»RFC 9309, Robots Exclusion Protocol · §2.2.1–2.2.2 · проверено 19.10.2026
Что это значит для сайта: пишите имя бота точно (регистр не важен) и давайте ему отдельную группу — тогда именно её правила и сработают, а не общий блок для всех.
Почему robots.txt это просьба, а не замок
robots.txt — добровольное соглашение. Крупные AI-компании, включая OpenAI, его уважают, но технически файл никого не останавливает: он лишь просит не заходить. Недобросовестный краулер правило проигнорирует. Если вам нужен жёсткий барьер, а не вежливая табличка, блокируйте на уровне сервера, CDN или WAF — там трафик режется физически, хотя это требует больше настройки и поддержки.
Полезная деталь из того же стандарта: если файл robots.txt недоступен из-за ошибок сервера, добросовестный краулер обязан вести себя так, будто запрещено всё. Поэтому следите, чтобы файл стабильно отдавался, иначе боты могут временно перестать обходить сайт целиком. Про остальных роботов и общую картину — в обзоре другие AI-боты на сайте и общий обзор.
Разбор ситуаций читателей
Задать вопросРазбор ситуации При аудите сайта клиента обнаружил, что GPTBot и ClaudeBot закрыты, хотя никто этого специально не делал. Оказалось, виноват пресет Cloudflare, который никто не пересматривал.
Ответ редакции ZrokЭто частый случай: платформы и хостинги включают блокировку AI-ботов по умолчанию, и robots.txt оказывается изменён не вами. Откройте свой-домен/robots.txt и поищите строки с GPTBot, OAI-SearchBot, ClaudeBot. Если рядом стоит Disallow, который вы не ставили, проверьте настройки Cloudflare в разделе управления ботами и приведите правила в тот вид, который нужен именно вам. После правки снова запросите robots.txt в браузере и убедитесь, что лишних запретов не осталось.
Разбор ситуации Хостинг-провайдер посоветовал включить в Cloudflare блокировку «ненужных ботов». Возникло подозрение, что совет сомнительный и так можно случайно навредить.
Ответ редакции ZrokПодозрение обоснованное. Массовая блокировка «всех ботов» одним переключателем легко задевает тех, кого вы хотели бы оставить, — например OAI-SearchBot, через который сайт попадает в поиск ChatGPT. Прежде чем включать, решите по каждому боту отдельно: GPTBot закрываем ради отказа от обучения, а поисковых ботов обычно оставляют. После включения проверьте, кто реально перестал заходить, по access-логу за несколько дней — так видно последствия, а не обещания.
Разбор ситуации Не понимаю, как галочка в Cloudflare может блокировать ботов, если Cloudflare не редактирует мой robots.txt.
Ответ редакции ZrokЭто два разных рычага. Часть настроек Cloudflare действительно дописывает сигнал в robots.txt — тогда бота вежливо просят не заходить. Но основная блокировка в Cloudflare работает на уровне трафика: запрос просто не доходит до сайта, независимо от содержимого robots.txt. Чтобы такой режим вообще действовал, трафик должен идти через Cloudflare (домен проксирован, а не только на DNS). Если Cloudflare у вас используется лишь для DNS, переключатель блокировки работать не будет.
Короткие вопросы и ответы
ОльгаЗапрет в robots.txt действительно работает?
Для добросовестных ботов — да. OpenAI заявляет, что GPTBot подчиняется robots.txt, и запрет означает отказ от использования контента в обучении. Но это добровольное правило: технически файл никого не держит. Для жёсткого запрета, который нельзя проигнорировать, нужна блокировка на уровне сервера, CDN или WAF.
ПавелНе навредит ли SEO блокировка AI-ботов?
В общем случае нет. Запрет AI-ботов закрывает именно AI-краулеры, а Google Search к ним не относится — его робот это не AI-бот, и обычная поисковая выдача не пострадает. Осторожность нужна в другом: не закройте заодно поисковых ботов самих AI-платформ, если хотите оставаться в их выдаче.
Источники
- OpenAI Crawlers documentationСтроки User-Agent, назначение GPTBot, разделение GPTBot, OAI-SearchBot и ChatGPT-User, адреса публикации IP.
- RFC 9309: Robots Exclusion ProtocolПравила сопоставления имени бота, выбор наиболее точной группы и поведение при недоступном robots.txt.
Источники проверены .