Как отличить настоящего AI-бота от подделки

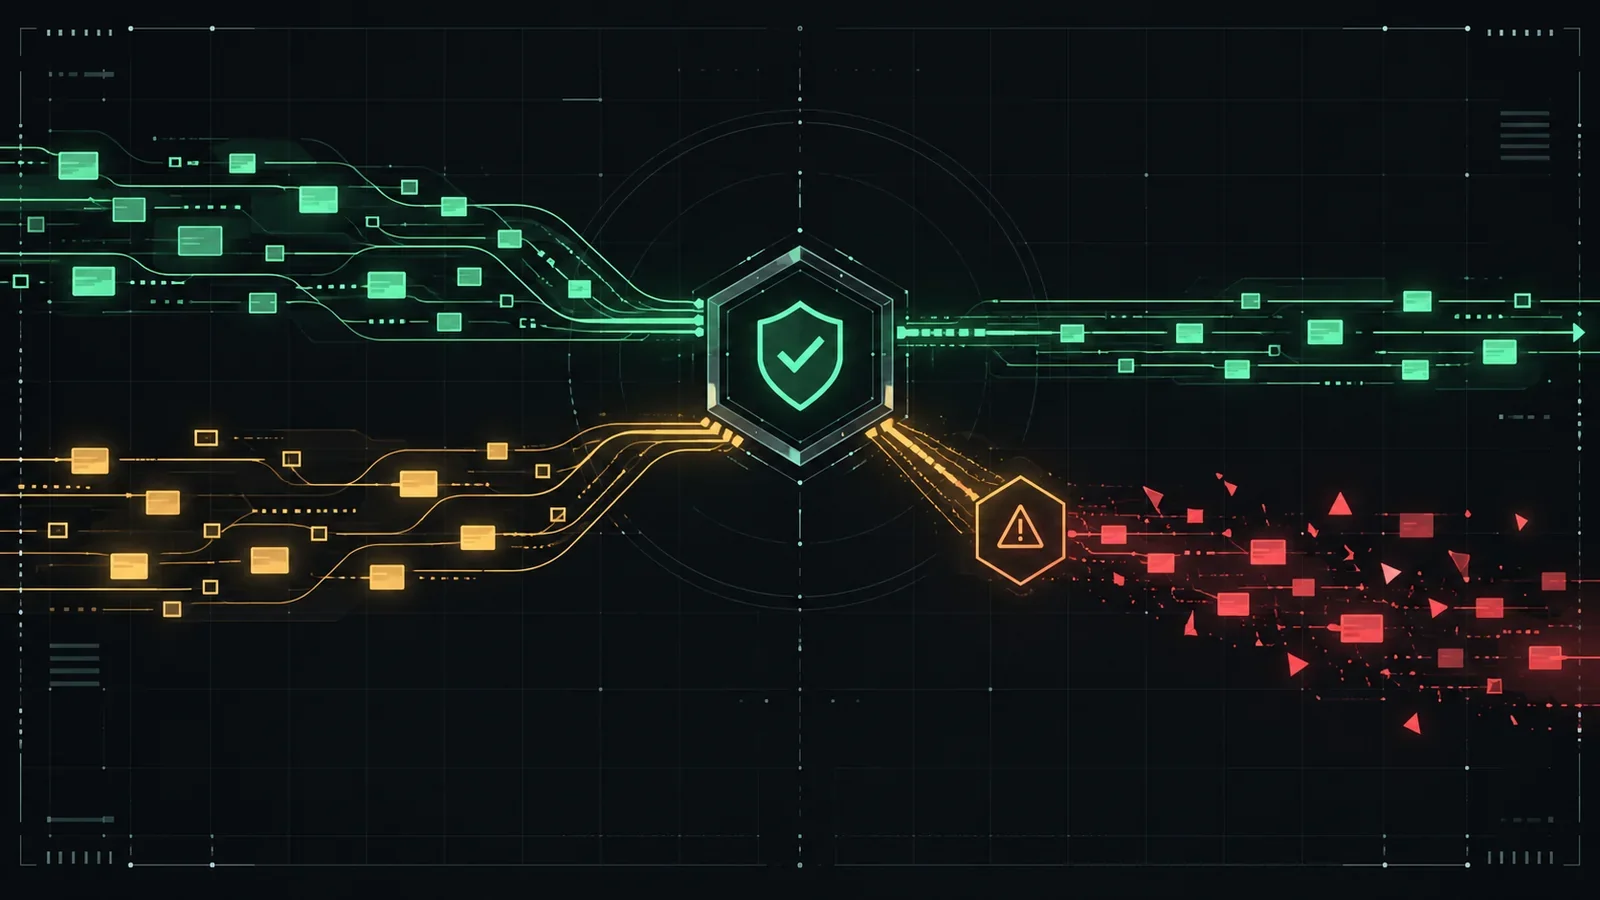
Имя в строке User-Agent задаёт сам клиент, поэтому GPTBot, ClaudeBot и другие имена легко подделать. Надёжно подтверждает визит только независимая проверка IP: обратный DNS с прямым подтверждением и сверка с официальными диапазонами оператора. По её результату и решают — пропустить визит, ограничить частоту или заблокировать.
Все разделы статьиОткрыть содержание
В логах и в аналитике всё чаще мелькают визиты, подписанные знакомыми именами: GPTBot, ClaudeBot, PerplexityBot и прочие AI-боты. Вы открываете access-лог и видите их буквально каждый день.
И сразу встаёт вопрос: пустить такой визит, придержать или закрыть доступ совсем.
Загвоздка в том, что имя в строке User-Agent задаёт сам клиент. Это его собственное заявление о себе, а не удостоверение личности, которое кто-то проверил и выдал.
Значит, поверить имени на слово нельзя. Придётся проверять.
И проверять его придётся вручную.
Хорошая новость в том, что имя из User-Agent — только отправная точка. Подлинность визита подтверждает независимая проверка исходного IP, которую оператор бота обычно сам даёт выполнить. На ней и строится всё дальнейшее решение о доступе.
Почему имени в User-Agent недостаточно
User-Agent — это обязательный HTTP-заголовок, который клиент отправляет с каждым запросом. В нём он сам называет, какой он продукт или бот.
Проще говоря, клиент представляется теми словами, какие выбрал сам.
Это заявление, не паспорт.
И верить этому заявлению напрямую нельзя по простой причине. User-Agent — обычная текстовая строка. Любой клиент выставляет в ней что угодно, а поменять её — вопрос одной настройки. Поэтому сама по себе строка ничего не гарантирует о том, кто её прислал.
Этим активно пользуются. Вредоносные боты подставляют чужие имена и выдают себя за Googlebot или за браузер Chrome.
Выходит, совпадение имени не доказывает, кто на самом деле пришёл на сайт.
Имя легко подделать.
Почему это важно прямо сейчас
Масштаб тут не фоновый. По оценкам специалистов по защите от ботов, сегодня почти половина всего веб-трафика приходится на автоматические клиенты, и мимо наивной проверки по имени проходит огромный поток запросов.
Разработчики приводят показательные случаи. Онлайн-сообщество Diaspora обнаружило, что около 24% его трафика шло от GPTBot, поискового робота OpenAI.
Википедия, по тем же наблюдениям, тратит до 35% трафика просто на обслуживание автоматических клиентов.
Это уже ощутимая доля всех запросов.
Складывается простое следствие для вашего решения. Раз имя подделывается, а ботов реально много, то по одной строке User-Agent нельзя обоснованно решить, пускать визит, ограничивать его или блокировать. Любой выбор окажется наугад.
Нужна проверка, которая не зависит от того, как клиент сам себя назвал.
И такую проверку оператор бота обычно сам же и даёт выполнить.
Но сначала строку визита надо научиться читать. Причём в логе, а не в аналитике.
Как прочитать и разобрать строку User-Agent
Искать User-Agent нужно в access-логе сервера, а не в JavaScript-аналитике.
Обычные счётчики краулеров почти не видят. Бот не исполняет скрипт на странице, поэтому в отчёт аналитики просто не попадает. Значит, по аналитике вы не узнаете о большей части визитов автоматических клиентов.
Обратная сторона тоже есть. В отчёты о прямом трафике боты попадают легко: в одном разборе веб-аналитики до 68% такого трафика оказалось ботами, без времени на странице и без referer.
Цифрам аналитики о ботах верить не стоит.
Смотрим в лог.
Как распознать запрос бота в логе nginx
Откройте access.log и найдите в строке поле User-Agent. Обычно оно стоит в самом конце записи.
Там клиент и представляется.
Вот как такая строка выглядит целиком.
66.249.66.1 - - [19/Oct/2026:08:14:22 +0000] "GET /catalog/item-512 HTTP/1.1" 200 8432 "-" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +…"Разобрать тут есть что. По полю User-Agent видно заявленное имя бота, а рядом, в начале строки, стоит IP, с которого пришёл запрос.
Уже есть за что зацепиться.
По одной такой строке видна заявка визита целиком: кто говорит, что он за бот, с какого адреса пришёл и к чему обращался. И именно этот IP дальше станет предметом независимой проверки.
Из чего состоит строка
Строка раскладывается на понятные части: имя продукта или бота, его версия и, как правило, ссылка на документацию оператора.
Ссылка подсказывает, чей это агент и где о нём почитать.
Синтаксис наизусть знать не нужно.
Достаточного навыка тут немного: уметь вычленить имя агента и источник, который за ним стоит.
Пример с ботами OpenAI
Например, у OpenAI несколько агентов — GPTBot, ChatGPT-User и OAI-SearchBot, и значения их строк User-Agent компания публикует в своей документации. Так эталон для сверки берётся у первоисточника, а не из догадок. У GPTBot строка выглядит примерно как compatible; GPTBot/1.4; +https://openai.com/gptbot, у поискового агента вместо этого стоит OAI-SearchBot/1.4.
Смотрим на него один раз как на образец чтения. Заучивать перечень не нужно.
И тут важная деталь. Одно имя не описывает всё поведение вендора, потому что под одним брендом работает сразу несколько агентов с разными задачами. Путать их нельзя.
На конкретике это видно сразу. У Anthropic отдельно работают ClaudeBot, Claude-SearchBot и Claude-User, у каждого своя роль. У OpenAI агентов тоже несколько, и у GPTBot для обучения и у ChatGPT-User для действий пользователя разное назначение.
Один оператор — ещё не один бот.
Полный разбор имён вынесен в отдельный справочник User-Agent AI-краулеров.
А пока имя всё ещё только заявление. Дальше проверяем, стоит ли за ним настоящий оператор.
Проверка подлинности через обратный DNS и официальные диапазоны IP
Главный принцип проверки простой: подлинность опирается не на имя, а на связку имени из User-Agent и исходного IP.
Крупные операторы — Apple, Bing, Google, OpenAI — специально поддерживают верификацию визита. Они публикуют способ убедиться, что запрос с конкретного адреса действительно принадлежит их боту, а не самозванцу с тем же именем.
Через обратный DNS мы, по сути, спрашиваем у самого вендора: его ли это визит.
Отвечает на этот вопрос адрес, а не строка с именем.
Обратный DNS с прямым подтверждением
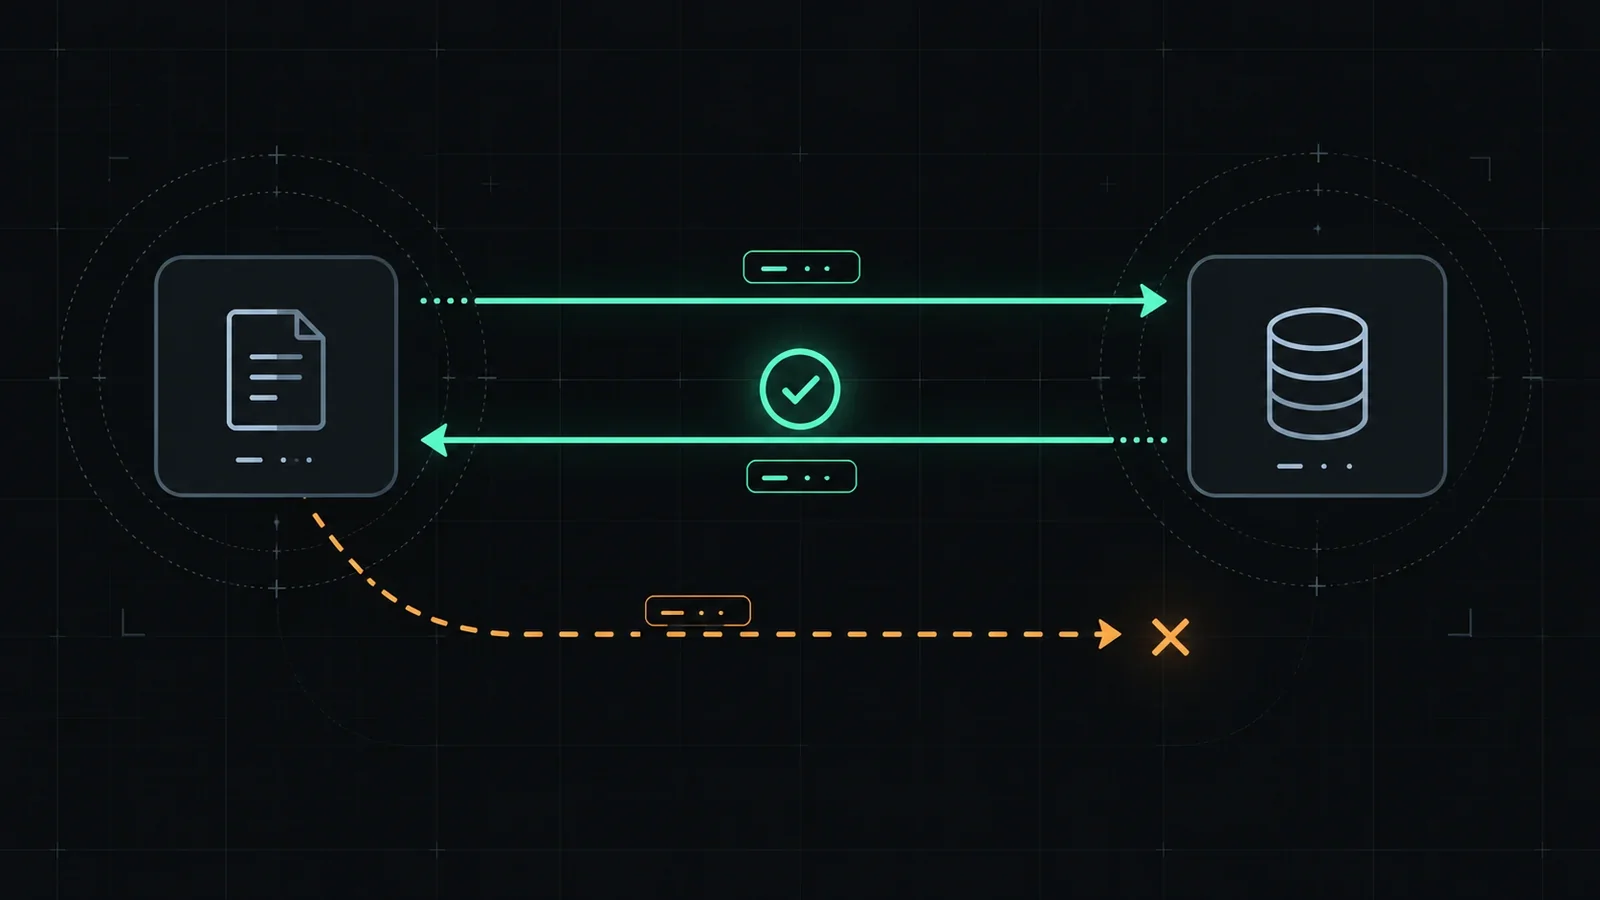
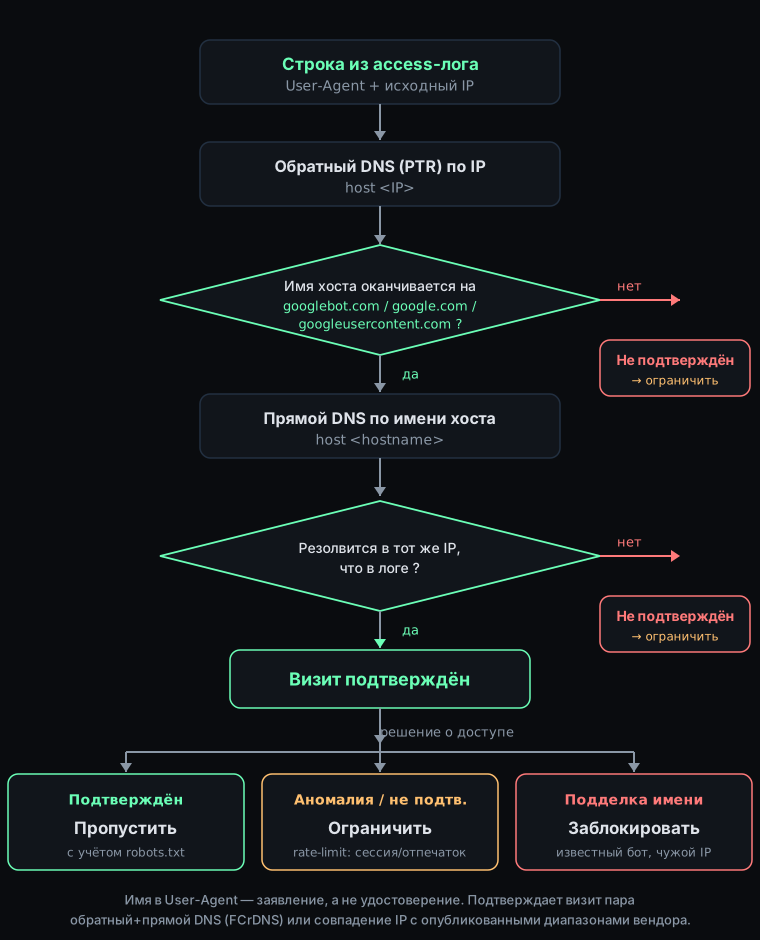
Метод называется forward-confirmed reverse DNS, и у него строгий порядок шагов.
Вот что и в какой последовательности мы проверяем.
- Взять IP визита из лога.
- Сделать по нему обратный DNS (PTR) командой
host. - Проверить, что имя хоста оканчивается на
googlebot.com,google.comилиgoogleusercontent.com. - Сделать прямой DNS уже по этому имени.
- Убедиться, что он резолвится в тот же самый IP.
Для массовой проверки добавляется ещё сверка IP с опубликованными CIDR-диапазонами оператора.
На деле это выглядит так:
host 66.249.66.1
1.66.249.66.in-addr.arpa domain name pointer crawl-66-249-66-1.googlebot.com.

host crawl-66-249-66-1.googlebot.com
crawl-66-249-66-1.googlebot.com has address 66.249.66.1
Сначала берём IP визита из лога, делаем по нему обратный DNS командой host и проверяем, оканчивается ли полученное имя хоста на официальный домен оператора — googlebot.com, google.com или googleusercontent.com.
Затем обязательно делаем прямой DNS уже по этому имени и убеждаемся, что он возвращает тот же самый IP, с которого пришёл запрос.
Без прямого шага проверка неполна.
Один подходящий суффикс — ещё не подтверждение.
Остановиться на красивом имени хоста нельзя вот почему. PTR-запись в своей зоне подделать несложно. А заставить прямой DNS оператора вернуть тот же IP самозванец уже не может. На этом и держится всё доказательство подлинности.
Это официальный метод Google: короткая выдержка из их страницы и пример команды host избавляют от похода в документацию.
Сверка с официальными диапазонами IP
Для массовых проверок есть второй слой. IP визита сверяют с официально опубликованными диапазонами оператора в формате CIDR. Это позволяет не делать DNS-запрос на каждый визит, а быстро отфильтровать заведомо чужие адреса по списку.
Например, OpenAI выкладывает свои диапазоны отдельными JSON-файлами по агентам. У поискового бота свой список адресов, у обучающего GPTBot свой, и сверять визит надо именно с файлом того агента, чьё имя стоит в строке.
Такую сверку легко автоматизировать из JSON вендора. Но именно поэтому перед использованием надо проверить дату и актуальность списка: адреса операторов со временем меняются, и устаревший список пропустит или отсечёт не тех. В published-файле OpenAI рядом с диапазонами стоит дата выгрузки, на неё и ориентируйтесь.
Старый список подведёт.
Три категории визитов Google
У Google не один тип визитов, и правила проверки у них разные. Это стоит держать в голове.
| Категория визита | reverse-DNS-маска | robots.txt | Файл диапазонов IP |
|---|---|---|---|
| Обычные краулеры (Googlebot) | crawl-*.googlebot.com или geo-crawl-*.geo.googlebot.com | всегда соблюдают | common-crawlers.json |
| Особые краулеры (AdsBot) | rate-limited-proxy-*.google.com | могут не соблюдать | special-crawlers.json |
| Пользовательские фетчеры | *.gae.googleusercontent.com или google-proxy-*.google.com | игнорируют | user-triggered-fetchers*.json |
Для решения важно вот что. Обычные краулеры всегда соблюдают robots.txt и ходят с масок вида crawl-*.googlebot.com. Особые краулеры вроде AdsBot его соблюдать не обязаны. А пользовательские фетчеры, запущенные человеком, игнорируют robots.txt сознательно, потому что действуют по запросу конкретного пользователя.
Отсюда следствие для проверки: у каждой категории свои reverse-DNS-маски и свой файл IP-диапазонов, и сверять визит нужно именно с её списком.
Один шаблон на всех не годится.
Что проверка даёт и чего не даёт
Будем честны о границах метода. Совпадение имени само по себе не доказывает ничего.
Неудачная сверка rDNS и IP означает, что визит не подтверждён как заявленный бот.
Это разные вещи.
И непройденная проверка — ещё не доказанный злой умысел. Это именно неподтверждённый визит, и относиться к нему стоит как к неподтверждённому, а не как к пойманному злоумышленнику.
Живой разбор проверки GPTBot вынесен отдельным примером.
Проверка отвечает на вопрос, настоящий визит или нет. А дальше вопрос в том, как вообще выглядит подделка.
Признаки поддельного бота и маскировки под краулер
Главный признак подделки один: заявленное имя не проходит проверку по обратному DNS и IP.
Поэтому хорошего бота подтверждает верификация — связка имени, IP и rDNS, а не сама строка в логе.
Имя не защищает.
Поведение выдаёт не меньше имени
Есть и второй слой сигналов. Это поведенческое несоответствие заявленной роли, аномальные паттерны запросов и резкие всплески частоты. Сюда же относится классический случай, когда известный User-Agent подставлен обычным или откровенно нежелательным трафиком, который притворяется краулером.
Условный пример аномалии: браузер, который обходит сайт со скоростью, недоступной человеку, уже повод присмотреться.
В логе такие сигналы видно напрямую. Это сотни тысяч запросов подряд без пауз, методичный обход всего каталога за раз, попытки достучаться до путей, закрытых в robots.txt, или выкачивание всех тяжёлых файлов подряд. Настоящий краулер ведёт себя аккуратнее и действует постепенно.
Поведение выдаёт.
Когда имя и IP не дают уверенности
Если имя и IP спорные, подключают дополнительные слои. Это репутация IP — дата-центр или домашний провайдер, VPN или прокси, из какой страны — по базам вроде MaxMind и IPinfo. И цифровые отпечатки клиента вроде JA3 и JA4, которые собирают хеш по параметрам сетевого соединения и запроса.
Отпечаток нужен не случайно. Настойчивые скрейперы ходят через пулы из десятков и сотен тысяч адресов, особенно на IPv6, и меняют IP от запроса к запросу. По одному адресу такого клиента не поймать, а вот сам клиент от запроса к запросу остаётся прежним, и отпечаток ловит именно его.
Это эскалация для спорных случаев, а не обязательный минимум на каждый визит.
Так глубоко нужно не всегда.
Рядом держим честную рамку: детектирование ботов не бывает точным на сто процентов.
Речь о взвешенном суждении по совокупности признаков, а не о гарантированном ответе.
Когда признаки собраны, остаётся превратить их в решение о доступе.
Как решить, пропустить, ограничить или заблокировать визит
Решение следует прямо из результата проверки. Подтверждённого бота обычно пропускают, рассчитывая, что он соблюдает robots.txt.
Неподтверждённый или явно поддельный визит ограничивают либо блокируют.
Сведём исход и действие вместе.
| Результат проверки | Что это значит | Решение |
|---|---|---|
| Подтверждён, совпали имя, IP и rDNS | настоящий заявленный бот | пропустить с учётом robots.txt |
| Не подтверждён или аномальное поведение | визит не доказан как заявленный бот | ограничить частоту по сессии или отпечатку |
| Явная подделка известного имени | самозванец под чужим именем | заблокировать |
Тут важно помнить, что детектирование не на 100% точно, поэтому таблица задаёт направление, а не автоматический приговор.
Как ограничивать частоту
Если решили ограничить, ограничивайте по сессии или по цифровому отпечатку клиента, а не по одному IP.
Причина простая. За одним адресом нередко скрываются десятки разных пользователей: общий офис, мобильный оператор, облачный прокси. Поэтому лимит по IP бьёт по случайным людям, а лимит по сессии или отпечатку попадает именно в источник нагрузки.
Цельтесь в источник.
Сначала проверить, потом блокировать
Показателен сторонний разбор, а не наш кейс. В нём автор увидел, что Google AdsBot за восемь часов обратился к сайту свыше шести тысяч раз. Прежде чем блокировать такой поток, он сверился с официальной страницей Google, чтобы отличить настоящий визит от инструмента, который лишь эмулирует googlebot.
Это чужое наблюдение из источника, а не кейс редакции. Но вывод из него вполне практичный.
Блок без проверки бьёт по своим.
Стоит помнить и про robots.txt. По стандарту RFC 9309 это добровольные правила: добросовестные краулеры их соблюдают, но сам файл не является средством контроля доступа, и проблемные боты его игнорируют. Поэтому реальную защиту даёт проверка визита, а не запись в robots.txt.
Чего ждать от защиты
Ожидание держим честное: решительного скрейпера полностью не устранить.
Реальная задача в другом — снизить нагрузку и усложнить подделку.
Проверка повышает издержки притворства, но абсолютной защиты не даёт.
Ограничивать или блокировать доступ владелец сайта вправе по собственным условиям использования и применимым нормам. При этом конкретное нормативное основание стоит сверять с актуальным первоисточником, а не считать заранее установленной нормой.
И основание это лучше прописать в условиях использования заранее.
Итог практичный. Проверка превращает догадку по имени в обоснованное решение по каждому визиту.