Кто такие AI-боты и краулеры на сайте и что с ними делать владельцу
Вы заглянули в логи сервера или в Яндекс.Метрику и увидели незнакомые имена вроде GPTBot или ClaudeBot. Или вам сказали, что AI-краулеров пора блокировать, а заодно что через них сайт попадает в ответы ChatGPT. Давайте разберёмся со всей темой сразу.

Если коротко: AI-боты и краулеры это автоматические программы ИИ-компаний, которые обходят сайты, чтобы собрать контент для обучения моделей, найти его для ответов вроде ChatGPT или выполнить разовый запрос пользователя. Сами по себе они сайту не вредят. Вопрос в том, какой именно бот пришёл, зачем и готовы ли вы отдать ему свой контент и лишнюю нагрузку, тем более что часть ботов приносит переходы и блокировать их невыгодно.
Все разделы статьиОткрыть содержание
Кто такие AI-боты и краулеры и зачем они заходят на сайт
Проще всего увидеть картину целиком так: к одному сайту тянется поток самых разных ИИ-краулеров, и часть из них проходит внутрь, а часть упирается в барьер выборочного доступа.
Обратите внимание: каждый такой поток решается отдельно, впустить его, ограничить или закрыть, и дальше мы разберём, как этот выбор делать.
AI-бот, он же краулер, с точки зрения вашего сайта это автоматический клиент. Он сам обходит страницы одну за другой, читает их и представляется строкой user-agent, а не открывает сайт руками, как обычный посетитель. По этой строке его и узнают, и ведёт он себя иначе: живой гость обычно открывает пару страниц, а краулер проходит сразу десятки подряд. Поэтому в журнале доступа он заметнее обычного визита, и его легко отличить, если знать, что искать.
Часть этих клиентов стоит знать в лицо, потому что именно их имена вы встретите и в логах, и в чужих robots.txt. Главные приходят от крупных ИИ-компаний: у OpenAI это GPTBot и отдельно OAI-SearchBot, у Anthropic, которая делает Claude, это ClaudeBot. Есть ещё Google-Extended от Google, PerplexityBot от Perplexity и CCBot, краулер проекта Common Crawl, данными которого пользуются многие. Эти несколько имён и составляют основной список, который реально попадается на обычном сайте, остальных десятки, но начинать знакомство стоит с них. Это ориентиры, а не полный справочник всех краулеров.
Зачем они вообще приходят
Причин ровно три, и они напрямую связаны с тем, что стоит за ботом. Первая это сбор контента, который может пойти на обучение языковых моделей. По документации OpenAI, например, GPTBot как раз обходит контент, который может использоваться для обучения их генеративных моделей, и это их прямая формулировка на дату проверки, 18 октября 2026 года. Вторая причина это формирование ответов в поисковых и ответных ИИ-системах, когда бот находит и показывает ваш материал. Третья отдельная: выполнить конкретное действие по запросу живого пользователя, прямо здесь и сейчас.
Где здесь польза: AI-боты поиска и ответов могут приносить переходы, когда человек спросил ИИ, тот сослался на вас, а читатель перешёл, и топ-источники такого трафика блокировать как раз не стоит. Где риск: часть визитов это использование вашего контента для обучения чужих моделей плюс дополнительная нагрузка на сервер, и отдавать всё это вы можете не хотеть. Поэтому вопрос стоит ставить конкретно: какой именно бот пришёл, зачем и готовы ли вы отдать ему свой контент и лишнюю нагрузку. Не каждый визит вам нужен.
И тут частая ошибка: многие закрывают этих ботов неосознанно, ставят готовый шаблон robots.txt или включают пресет на хостинге, не проверяя, что именно там закрыто. А закрытым может оказаться как раз полезный источник трафика. Детальный разбор каждого бота и методику проверки подлинности по IP мы выносим в отдельные материалы, здесь же общая картина и помощь выбрать свою ситуацию.
В чём разница между ботами обучения, ботами поиска и ботами-агентами
Ботов удобно делить на три группы по тому, зачем они приходят. Вот эти три группы одним взглядом.
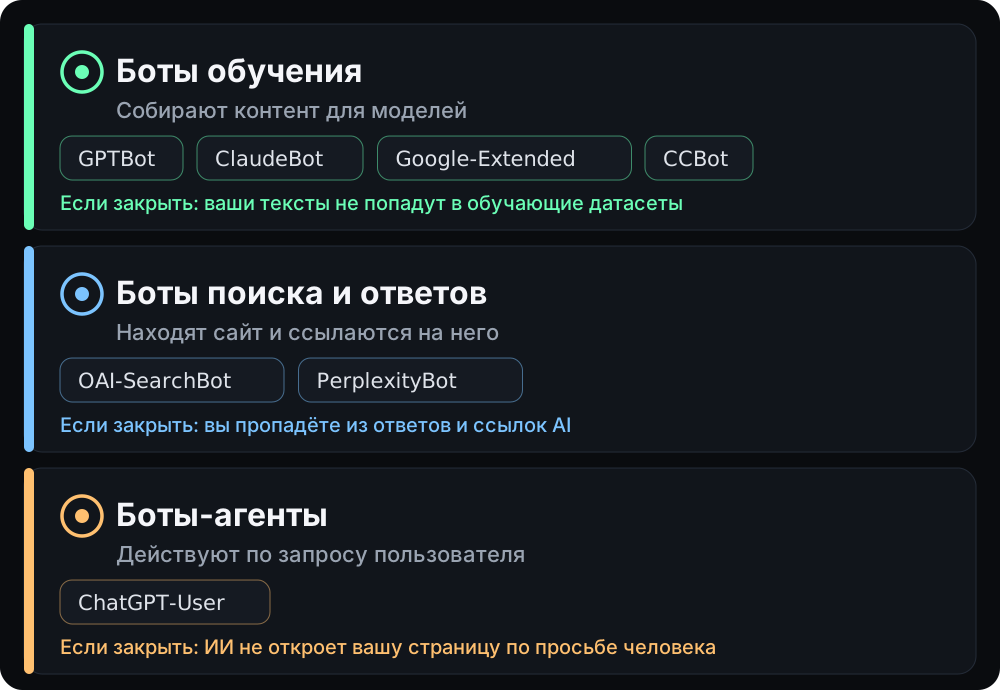
Запомните сам принцип деления по цели визита, а точные имена в каждой группе разберём ниже и сведём в таблицу.
Боты обучения собирают контент для моделей
К ним относятся GPTBot у OpenAI и ClaudeBot у Anthropic, они собирают веб-контент, который может пойти на обучение генеративных моделей. По документации Anthropic, запрет ClaudeBot в robots.txt сигнализирует, что ваши будущие материалы стоит исключить из обучающих датасетов; у OpenAI формулировка похожая: запрет GPTBot говорит, что контент не следует использовать для обучения. Имена разные, задача у этой пары общая.
Особняком стоит Google-Extended. По документации Google это самостоятельный управляющий токен robots.txt, которым издатель решает, можно ли использовать обойдённый контент для обучения будущих моделей Gemini. Запрет такому боту это сигнал, а не технический замок на двери.
Боты поиска и ответов находят и показывают
Эти приходят ради видимости. PerplexityBot, по документации Perplexity, предназначен находить сайты и ссылаться на них в результатах Perplexity и не используется для обхода контента ради обучения базовых моделей. OAI-SearchBot у OpenAI тоже относится к поиску, а не к обучению, это отдельный поисковый токен, и обучающие датасеты тут ни при чём. Закрывая такого бота, вы влияете на свою видимость в ответах, а не на попадание в датасеты.
Боты-агенты действуют по запросу пользователя
Пример это ChatGPT-User, отдельный токен OpenAI. Он приходит, когда конкретный пользователь задал вопрос и системе нужно сходить на страницу ради его запроса; по документации OpenAI, это не массовый автоматический обход сайта. Агент работает здесь и сейчас, под одного человека.
Чтобы всё это держать перед глазами, вот три категории рядом.
| Тип бота | Примеры имён | Зачем приходит | Что значит ограничить |
|---|---|---|---|
| Боты обучения | GPTBot, ClaudeBot, Google-Extended | Собирают контент, который может пойти на обучение моделей | Сигнал исключить ваш контент из обучающих датасетов |
| Боты поиска и ответов | OAI-SearchBot, PerplexityBot | Находят и показывают сайт в результатах и ответах | Влияете на видимость в ответных системах |
| Боты-агенты | ChatGPT-User | Выполняют разовое действие по запросу пользователя | Ограничиваете отдельные действия, а не массовый обход |
Почему различие важно для решения: закрывая бота обучения, вы влияете на то, попадёт ли ваш контент в чужие обучающие датасеты. Закрывая бота поиска или агента, вы влияете на видимость и на действия в ответных системах. Поэтому выбор, кого ограничивать, зависит от того, что вам важнее: не отдавать контент на обучение или остаться заметным в ответах ИИ.
Одно имя в таблице ведёт себя не как остальные: Google-Extended стоит среди ботов, но в логах отдельной строкой вы его не увидите. По документации Google, у него нет собственной строки user-agent в HTTP-запросах, сам обход идёт обычными user-agent Google, а токен работает только как управляющая запись в robots.txt. Значит, отсутствие имени в строке лога ещё не значит, что бота нет.
Как визит бота выглядит в логах и по каким именам его узнать
Смотреть есть куда. Журнал доступа сервера, он же access-лог, записывает каждый визит, а Яндекс.Метрика показывает динамику переходов из ботовых источников, и вместе они дают понять, кто к вам реально ходит. В access-логе гость виден построчно, а в Метрике те же визиты заметны по динамике переходов из источников, связанных с ИИ-системами.
Сама строка визита выглядит примерно так:
"GET /blog/ai-boty HTTP/1.1" 200 "Mozilla/5.0 (compatible; GPTBot/1.2)"Читается она так: имя и версия бота стоят в user-agent, вот эта часть GPTBot/1.2. Примерно так в access-логе и выглядит реальный визит краулера OpenAI, по нему вы и узнаёте гостя. Обратите внимание именно на имя и версию в строке, потому что первый признак бота это и есть знакомое имя известного краулера в user-agent.
Но на одно имя полагаться нельзя. User-agent это просто текст, который клиент присылает сам, и подделать его может кто угодно, поэтому имя в логе это первый признак, а не доказательство, что перед вами настоящий бот вендора. Для настоящей уверенности имя сверяют с диапазонами IP-адресов, которые вендоры публикуют отдельно, и с обратным DNS: совпали имя и адрес из официального диапазона, тогда это он. Сама детальная процедура такой проверки это тема отдельного материала, здесь мы её только обозначаем, а дальше она ведёт к двум ситуациям: подозрению на подделку и блокировке на уровне сервера, где появляется настоящая гарантия.
Что можно сделать с ботом и чем отличаются пропуск, ограничение и блокировка
Вариантов по сути три: пропустить, ограничить или заблокировать, и у каждого своя реальная цена. Чтобы выбирать осознанно, полезно увидеть путь запроса от бота до сайта и два барьера на этом пути.
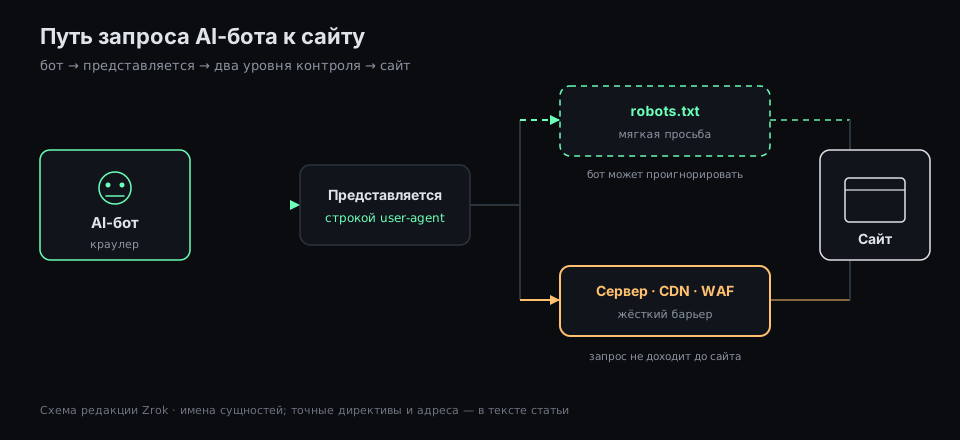
Главное отличие на схеме: robots.txt бот может и проигнорировать, а барьер на сервере, CDN или WAF запрос до сайта просто не пропустит.
Пропустить и оставить доступ открытым
Бот обучения или поиска может приносить пользу, а топ-источники AI-трафика блокировать как раз невыгодно, так что открытый доступ это нормальный рабочий выбор. Но и здесь полезно сначала понять, какой именно бот и зачем к вам проходит: оставить доступ открытым это тоже решение, которое стоит принять осознанно.
Ограничить через robots.txt как мягкую просьбу
Файл robots.txt лежит в корне домена, по адресу вида site.com/robots.txt, и правила в нём задаются по конкретному имени бота; открыть и прочитать его может каждый. Работает это по стандарту Robots Exclusion Protocol, он же RFC 9309.
В тексте стандарта прямо сказано: правила robots.txt краулеров просят соблюдать, и эти правила не являются формой авторизации доступа.
То есть это вежливая просьба, которую бот имеет техническую возможность проигнорировать, и будут ли боты слушаться, остаётся на их совести.
Дальше частая ловушка. Правило для user-agent со звёздочкой, которое закрывает всех подряд, AI-краулеров обычно не ловит: у них отдельные собственные имена, и общее правило они под себя не применяют. Блокировать их нужно поимённо: GPTBot, ClaudeBot, Google-Extended, PerplexityBot, CCBot и так далее, каждого своей записью. Выглядит это просто:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /Заблокировать на уровне сервера, CDN или WAF
Это более серьёзный технический барьер и, по сути, единственная гарантия против бота, который игнорирует robots.txt. Настраивается он на самом сервере, на стороне CDN или в WAF и работает независимо от того, уважает бот robots.txt или нет, потому что запрос просто не доходит до сайта. Расплата за надёжность это сложность: поддерживать правило на сервере тяжелее, чем строку в текстовом файле.
Для тех, кто на Cloudflare, есть готовый переключатель блокировки AI-ботов, он включается одним действием. Важная деталь: он срабатывает, только если домен реально проксируется через Cloudflare, а не используется для одного лишь DNS, без проксирования трафика кнопка просто не сработает. При этом обычный поисковый Googlebot AI-ботом не считается, и такой переключатель его не трогает.
Два уровня ограничения стоит сравнить по цене:
- robots.txt: правится в одном текстовом файле, точечно по именам, не требует инженерии. Но соблюдение добровольное, и упрямого бота он не остановит.
- Сервер, CDN или WAF: даёт настоящую гарантию, запрос не доходит до сайта. Но требует настройки, доступа к инфраструктуре и поддержки.
Как убедиться, что получилось именно то, что хотели. Откройте свой robots.txt и посмотрите действующие user-agent и Disallow, а правила протестируйте в Google Search Console, в Bing Webmaster Tools или во внешнем валидаторе robots.txt, указав URL и имя бота. Там же видно, какое правило реально применилось к конкретному имени, а не только что вы хотели применить.
И помните про цену: при блокировке вы можете потерять именно AI-трафик. Блокировка известных AI-ботов и вред обычному поисковому SEO это разные вещи, привычный поисковый Googlebot в списки AI-краулеров не входит. Поэтому блокировку включайте осознанно, взвешивая потерю AI-трафика против того, какой контент и какую нагрузку вы готовы отдавать ботам.
Короткий FAQ по частым вопросам
Как галочка в Cloudflare блокирует ботов, если она не правит robots.txt?
Cloudflare фильтрует трафик на своём уровне, пока домен проксируется через него, и запрос бота отсекается ещё до сайта, поэтому robots.txt трогать не нужно. Без проксирования, на одном DNS, переключатель работать не будет.
Не навредит ли блокировка AI-ботов обычному поиску?
Обычный поисковый Googlebot AI-ботом не считается, и список AI-краулеров его не затрагивает. Но переходы из ChatGPT, Perplexity и подобных систем вы при блокировке теряете.
Насколько реально боты слушаются Disallow?
robots.txt остаётся просьбой, соблюдение добровольное. Если доступ нужно закрыть наверняка, блокируют на уровне сервера.
Выберите свою ситуацию и перейдите к нужному разбору
Выберите случай, который ближе к вашему, и двигайтесь к детальному разбору.
Не узнаю бота
Короткий порядок такой: найдите имя в user-agent, сопоставьте его с известными AI-краулерами и их назначением по таблице выше, а потом решите, нужен ли вам этот бот, для первого решения этого обычно хватает. Подробное опознание конкретных имён мы разбираем в отдельном материале.
Подозреваю подделку
Имя в user-agent подделать легко, поэтому само по себе оно ничего не доказывает. Надёжная проверка идёт по опубликованным вендором диапазонам IP и обратному DNS, полную процедуру мы выносим в отдельную статью и здесь не раскрываем.
Хочу закрыть доступ
robots.txt это мягкая просьба по имени бота, а гарантию даёт только блок на уровне сервера, CDN или WAF; и не забудьте про возможную потерю AI-трафика. Пошаговую настройку мы показываем в отдельном материале.
Как это выглядит на практике, видно по наблюдениям других владельцев сайтов. Автор одного комментария рассказывает, что при аудите сайта нашёл заблокированными GPTBot и ClaudeBot, причём не намеренно: их закрыл пресет Cloudflare, который никто не проверял. После того как это исправили, он отметил рост AI-переходов. Это его наблюдение, а не обещание такого же результата у вас.
Другой владелец пишет, что совет хостинг-провайдера привёл к блокировке не тех ботов, и хорошо, что он вовремя это заметил и откатил. Тоже личное наблюдение автора комментария.
Вывод из обоих один: чужие готовые пресеты и советы по блокировке стоит перепроверять по своему robots.txt и своим логам, а не принимать на веру. После любой чужой настройки проверьте, кого вы на самом деле закрыли.
Гарантирует ли пропуск бота попадание в ответы ChatGPT и других систем
Поставим вопрос прямо: если пропустить AI-бота, окажется ли сайт в ответах ChatGPT и других систем? Именно как вопрос, а не как обещание. Гарантии нет, и вот почему. Пропуск бота делает только одно: даёт ему техническую возможность обойти и использовать ваш контент, но доступность это ещё не попадание. А попадёт ли материал в ответ, зависит от того, как сами системы выбирают и ранжируют источники, и это их внутренняя логика. Говорить тут можно про наблюдения и гипотезы, но не про обещанный результат в ИИ-выдаче.
Рядом с этим мифом часто всплывает файл llms.txt. Это предложенный стандарт, похожий по идее на robots.txt, но адресованный языковым моделям: он даёт им краткую карту сайта с самым ценным контентом. На момент изученных источников его официально не поддерживал ни один крупный LLM-провайдер. Это не замена robots.txt и тем более не гарантия попадания в ответы ИИ, так что приоритетной задачей его делать не стоит.
У блокировки, кстати, есть обратная сторона: закрыв AI-ботов, вы рискуете лишить сайт именно AI-трафика. Поэтому и пропуск, и блокировка это осознанное решение, а не действие по умолчанию. Самое полезное, что можно сделать прямо сейчас, это посмотреть, какие боты вообще приходят на ваш сайт, и уже от этого отталкиваться.
Источники
- RFC 9309: Robots Exclusion ProtocolСтандарт файла robots.txt: правила краулеров просят соблюдать, это не форма авторизации доступа.
- OpenAI: обзор краулеров (GPTBot, OAI-SearchBot, ChatGPT-User)Назначение токенов OpenAI и смысл запрета в robots.txt.
- Anthropic: ClaudeBot и блокировка краулераЧто означает запрет ClaudeBot в robots.txt.
- Google: краулеры и Google-ExtendedУправляющий токен robots.txt без собственного user-agent.
- Perplexity: PerplexityBotПоиск и ссылки, а не обход ради обучения базовых моделей.
Источники проверены .