Справочник AI-краулеров с владельцами, назначением и User-Agent

Вы увидели в логах строку вида *Bot и не понимаете, кто её оставил. Этот справочник сопоставляет токен из строки User-Agent с владельцем бота, показывает его назначение, точную строку в логах и то, уважает ли он robots.txt. Нашли имя — определили компанию, цель визита и решение, пускать его или закрывать.
Все разделы статьиОткрыть содержание
Справочник основных AI-краулеров и их владельцев
AI-краулер ходит по вашему сайту так же, как обычный поисковый робот: запрашивает страницы и представляется строкой User-Agent. Разница в том, зачем он пришёл. Классический робот вроде Googlebot индексирует страницы для поисковой выдачи. AI-краулер собирает контент для обучения языковой модели или для генерации ответов в чат-интерфейсе. По строке в логе эти задачи не всегда видны, поэтому и нужен справочник.
За основными ботами стоит небольшой набор операторов. OpenAI управляет ботами GPTBot, OAI-SearchBot и агентом ChatGPT-User. Anthropic держит три бота: ClaudeBot, Claude-SearchBot и Claude-User. Perplexity использует PerplexityBot и Perplexity-User. Google вводит отдельный токен Google-Extended. Common Crawl запускает CCBot для открытого датасета, которым затем пользуются многие другие проекты. Названия ботов пишутся латиницей и в логах, и в robots.txt, поэтому в таблице они сохранены как есть.
Ниже сведены все основные боты в одном месте. По каждому вы видите владельца, назначение, строку User-Agent и отношение к robots.txt. Строки даны так, как они приходят в лог, чтобы их можно было искать глазами.
| Бот | Владелец | Назначение | Строка User-Agent | robots.txt |
|---|---|---|---|---|
| GPTBot | OpenAI | Обучение базовых генеративных моделей | compatible; GPTBot/1.4; +https://openai.com/gptbot | Да, токен GPTBot |
| OAI-SearchBot | OpenAI | Поиск и ответы в ChatGPT | compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot | Да, токен OAI-SearchBot |
| ChatGPT-User | OpenAI | Действие по запросу пользователя в ChatGPT | compatible; ChatGPT-User/1.0; +https://openai.com/bot | Запрос пользователя, robots.txt может не применяться |
| ClaudeBot | Anthropic | Сбор данных для обучения моделей Anthropic | Официальную HTTP-строку вендор не публикует; наблюдаемая у сторонних агрегаторов compatible; ClaudeBot/1.0; +claudebot@anthropic.com | Да, токен ClaudeBot |
| Claude-SearchBot | Anthropic | Индексация для качества поисковых ответов | Официальную HTTP-строку вендор не публикует; токен Claude-SearchBot | Да, токен Claude-SearchBot |
| Claude-User | Anthropic | Fetch по запросу пользователя Claude | Официальную HTTP-строку вендор не публикует; токен Claude-User | Да, управляется токеном Claude-User, по документации Anthropic соблюдает его |
| Google-Extended | Управление использованием контента для обучения Gemini и grounding | Отдельной строки User-Agent нет, это robots.txt-токен | Сам управляющий токен, на Google Поиск не влияет | |
| PerplexityBot | Perplexity | Индексация для ответов Perplexity | compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot | Да, токен PerplexityBot |
| Perplexity-User | Perplexity | Fetch по запросу пользователя | compatible; Perplexity-User/1.0; +https://perplexity.ai/perplexity-user | Обычно игнорирует, запрос пользователя |
| CCBot | Common Crawl | Общий открытый датасет, используется в том числе для обучения | CCBot/2.0 (https://commoncrawl.org/faq/) | Да, токен CCBot |
| Bytespider | ByteDance | Сбор данных для обучения моделей ByteDance | По сторонним данным compatible; Bytespider; spider-feedback@bytedance.com, первоисточником не подтверждено | По сторонним данным соблюдает непоследовательно |
Принадлежность операторам и строки для OpenAI, Perplexity и Common Crawl взяты из их собственной документации (OpenAI, Perplexity, Common Crawl, проверено 19 октября 2026). По ботам Anthropic вендор публикует назначение и robots.txt-токены, но не приводит точные HTTP-строки User-Agent, поэтому в таблице они помечены отдельно. Строка Bytespider собрана только по сторонним агрегаторам, официальной страницы ByteDance найти не удалось, и достоверность этих данных низкая.
Перечень расширяемый. Кроме перечисленных, в логах встречаются Amazonbot (Amazon), Applebot и управляющий токен Applebot-Extended (Apple), Meta-ExternalAgent и facebookexternalhit (Meta). Запись для них читается так же: находите токен, смотрите владельца и назначение. Полным каталогом справочник быть не старается, а значения чужих ботов без проверки в него не попадают.
Читать чужие записи помогает одно правило. Один вендор часто держит несколько ботов под разные задачи, и значение имеет именно токен, а не компания целиком. У Meta превью ссылок в приложениях собирает facebookexternalhit, а контент для обучения моделей и индексации обходит отдельный Meta-ExternalAgent. Это две разные записи, и путать их не стоит: facebookexternalhit обучающим краулером не является. У Apple поиск в Spotlight, Siri и Safari кормит Applebot, а отказ от использования контента в обучении оформляется отдельным токеном Applebot-Extended, у которого собственного агента в логах нет. Поэтому в логах ориентируйтесь на точное имя.
Зачем краулеры ходят по сайтам
Назначение бота определяет, стоит ли его пускать. Все перечисленные боты раскладываются на три задачи: собрать данные для обучения модели, обслужить поиск и генерацию ответа, выполнить действие по запросу живого пользователя. По этой задаче вы и принимаете решение.
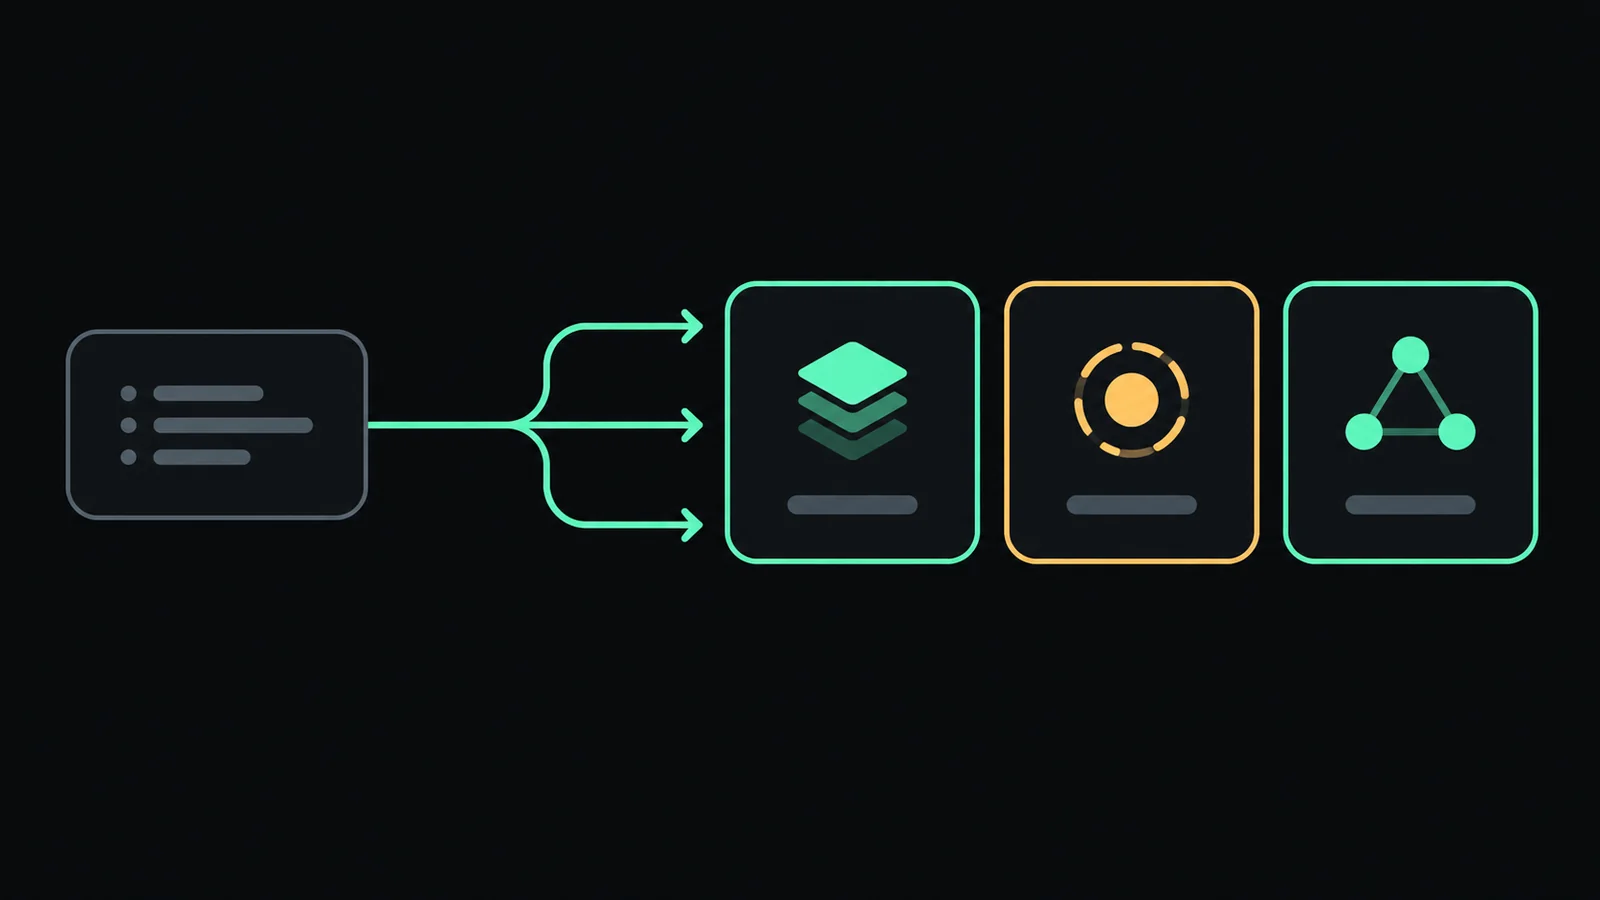
На схеме видно, как эти три ветки расходятся от одной строки лога: слева обучение модели, в центре поиск и ответы, справа агентный fetch по запросу человека. Ветка задаёт и решение по доступу, поэтому дальше разбираем их по очереди.
Боты для обучения моделей
Эти боты собирают контент, который затем идёт в обучающие датасеты. GPTBot обходит страницы, которые могут использоваться для обучения базовых генеративных моделей OpenAI, и запрет GPTBot в robots.txt означает отказ от такого использования. ClaudeBot делает то же для моделей Anthropic. CCBot формирует открытый репозиторий Common Crawl, который многие берут как готовый датасет. Обучающего бота владельцы контента чаще закрывают, когда не хотят, чтобы их материалы учили чужую модель.
Та же логика у менее известных ботов. Amazonbot обходит сайт для продуктов Amazon и, по документации компании, может использоваться для обучения её AI-моделей. Applebot питает поиск в Spotlight, Siri и Safari, но его данные тоже могут идти в обучение базовых моделей Apple, и именно для отказа от этого введён токен Applebot-Extended. Решение везде одно: хотите закрыть обучение — смотрите, какой токен за него отвечает.
Боты для поиска и ответов
Поисково-ответные боты выводят ваш сайт в ответах, которые система показывает пользователю. OAI-SearchBot отвечает за показ сайтов в поисковых функциях ChatGPT, и сайт, закрывший OAI-SearchBot, в этих ответах не появится (документация OpenAI, проверено 19 октября 2026). PerplexityBot выводит и цитирует сайты в результатах Perplexity и для обучения базовых моделей не используется. Claude-SearchBot индексирует страницы ради качества поисковых ответов Claude. Такого бота обычно держат открытым, если нужна видимость в AI-ответах.
Различие между обучающим и поисковым ботом и есть главная развилка решения. Закрыли обучающего — защитили контент от использования в модели. Закрыли поискового — выпали из его ответов. Поэтому решение принимают по конкретному токену.
Агентные запросы от пользователя
Третья задача это fetch по запросу живого пользователя. Perplexity-User заходит на страницу, чтобы помочь с точным ответом и дать ссылку, и для обучения не используется. ChatGPT-User работает так же в интерфейсе ChatGPT. Claude-User тоже делает fetch по запросу пользователя Claude, но, в отличие от них, по документации Anthropic управляется токеном Claude-User в robots.txt и соблюдает его. Запрос инициирует человек, а не фоновый обход, поэтому у Perplexity-User и ChatGPT-User правила robots.txt часто не применяются.
Отдельно стоит Google-Extended. Это управляющий robots.txt-токен, которым издатель решает, можно ли использовать его контент для обучения моделей Gemini и для grounding, то есть подачи контента в модель во время запроса. Google-Extended не влияет на включение сайта в Google Поиск и не является сигналом ранжирования (документация Google, проверено 19 октября 2026). Эти две оговорки держите вместе, иначе легко закрыть лишнее и решить, что пострадает поиск.
User-Agent краулеров и соблюдение robots.txt
Чтобы узнавать ботов в логах, полезно видеть их строки целиком, а не только имя. Вот как выглядят подтверждённые вендорами строки, когда приходят в журнал доступа.
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot
CCBot/2.0 (https://commoncrawl.org/faq/)
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; Perplexity-User/1.0; +https://perplexity.ai/perplexity-user)
Обратите внимание на номер версии: у GPTBot это 1.4, но в логах встречается и 1.2. Версия меняется, поэтому опознавать бота надо по имени, а не по всей строке.
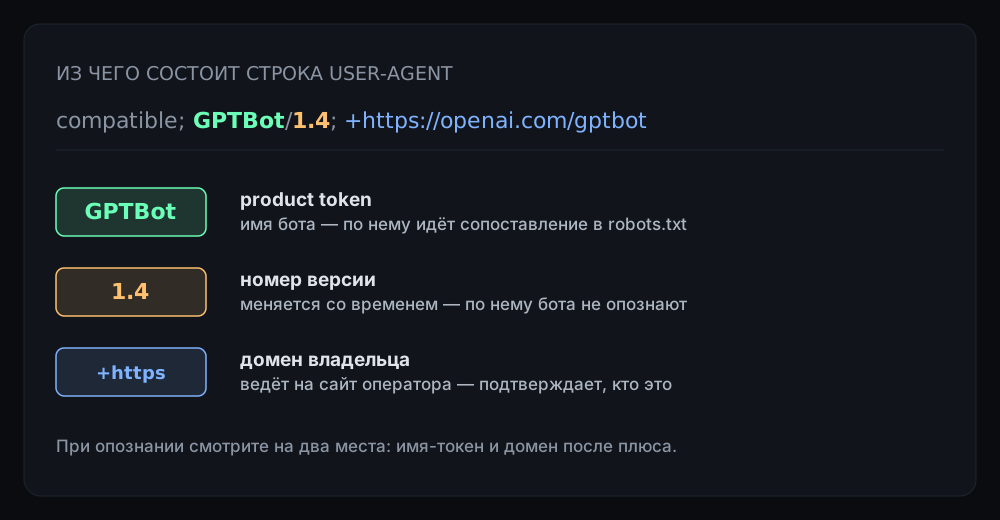
На разборе одна строка разложена на части: сам токен GPTBot, номер версии после слэша и ссылка на домен владельца после плюса. Для поиска по справочнику и для записи в robots.txt вам нужен только токен — остальные части меняются от визита к визиту.
Как токен в robots.txt связан со строкой в логах
Имя бота в robots.txt это product token. Он же является подстрокой полной строки User-Agent, которую вы видите в логе. По RFC 9309 (параграф 2.2.1, проверено 19 октября 2026) краулер обязан сопоставлять product token с собой без учёта регистра, поэтому записи GPTBot, gptbot и GPTBOT для бота означают одно и то же имя. Пути в правилах при этом сопоставляются уже с учётом регистра. Так выглядит простейшее правило для обучающего бота:
User-agent: GPTBot
Disallow: /
Подтверждённые токены крупных вендоров это GPTBot и OAI-SearchBot у OpenAI, ClaudeBot, Claude-User и Claude-SearchBot у Anthropic, PerplexityBot и Perplexity-User у Perplexity, CCBot у Common Crawl и Google-Extended у Google. Google-Extended отдельной строки User-Agent не имеет: сам обход Google делает существующими строками, а токен работает только как управляющая запись в robots.txt. В логах вы его как User-Agent не увидите, но в robots.txt он контролирует обучение Gemini.
У каждого вендора свои тонкости поведения. Amazonbot прямо заявляет, что соблюдает Robots Exclusion Protocol по RFC 9309, но не поддерживает директиву crawl-delay. Applebot при отсутствии в robots.txt правил для его токена следует инструкциям, написанным для Googlebot. Такие детали вынесены на детальные страницы ботов, но общий принцип один: правило адресуется токену, и имя токена надо брать точно.
Соблюдение robots.txt остаётся добровольным
robots.txt это мягкая просьба, а не технический барьер. Крупные вендоры заявляют, что их автоматические краулеры подчиняются директивам, и в этом им обычно можно доверять. А вот пользовательские fetch-агенты ведут себя иначе. Perplexity прямо пишет, что Perplexity-User инициирован пользователем и поэтому обычно игнорирует правила robots.txt (документация Perplexity, проверено 19 октября 2026). То же касается ChatGPT-User и Meta-ExternalFetcher.
Значит, если бота нужно закрыть гарантированно, одной записи в robots.txt мало. Нужен барьер на уровне сервера: правило в веб-сервере, WAF или на балансировщике, которое отвечает агенту отказом. robots.txt остаётся для тех, кто его уважает, а серверный барьер работает для всех.
Есть и обратная проблема: имя в строке User-Agent можно подделать. Common Crawl прямо предупреждает, что под CCBot маскируются чужие обходчики, и подлинность приходится проверять отдельно. Поэтому строка в логе сама по себе личность бота не доказывает. Пошаговую проверку подлинности по IP мы выносим в соседний материал о распознавании ботов, здесь достаточно помнить, что доверять одной строке нельзя.
Как пользоваться справочником при незнакомом имени в логах
Порядок опознания простой. Берёте строку User-Agent из лога, выделяете в ней product token, то есть имя вида *Bot или *-User, и ищете его в таблице справочника. Получаете владельца, назначение и подтверждённую строку. Дальше решаете по назначению: обучающего закрыть или оставить, поисково-ответного держать открытым ради видимости, агентного учитывать как действие пользователя. С агентным ботом есть нюанс: заблокировав его жёстко, вы можете сломать то, за чем пришёл реальный человек, например подтягивание вашей страницы в ответ Perplexity или ChatGPT. Поэтому для fetch-агентов решение обычно мягче, чем для фонового обучающего обхода.
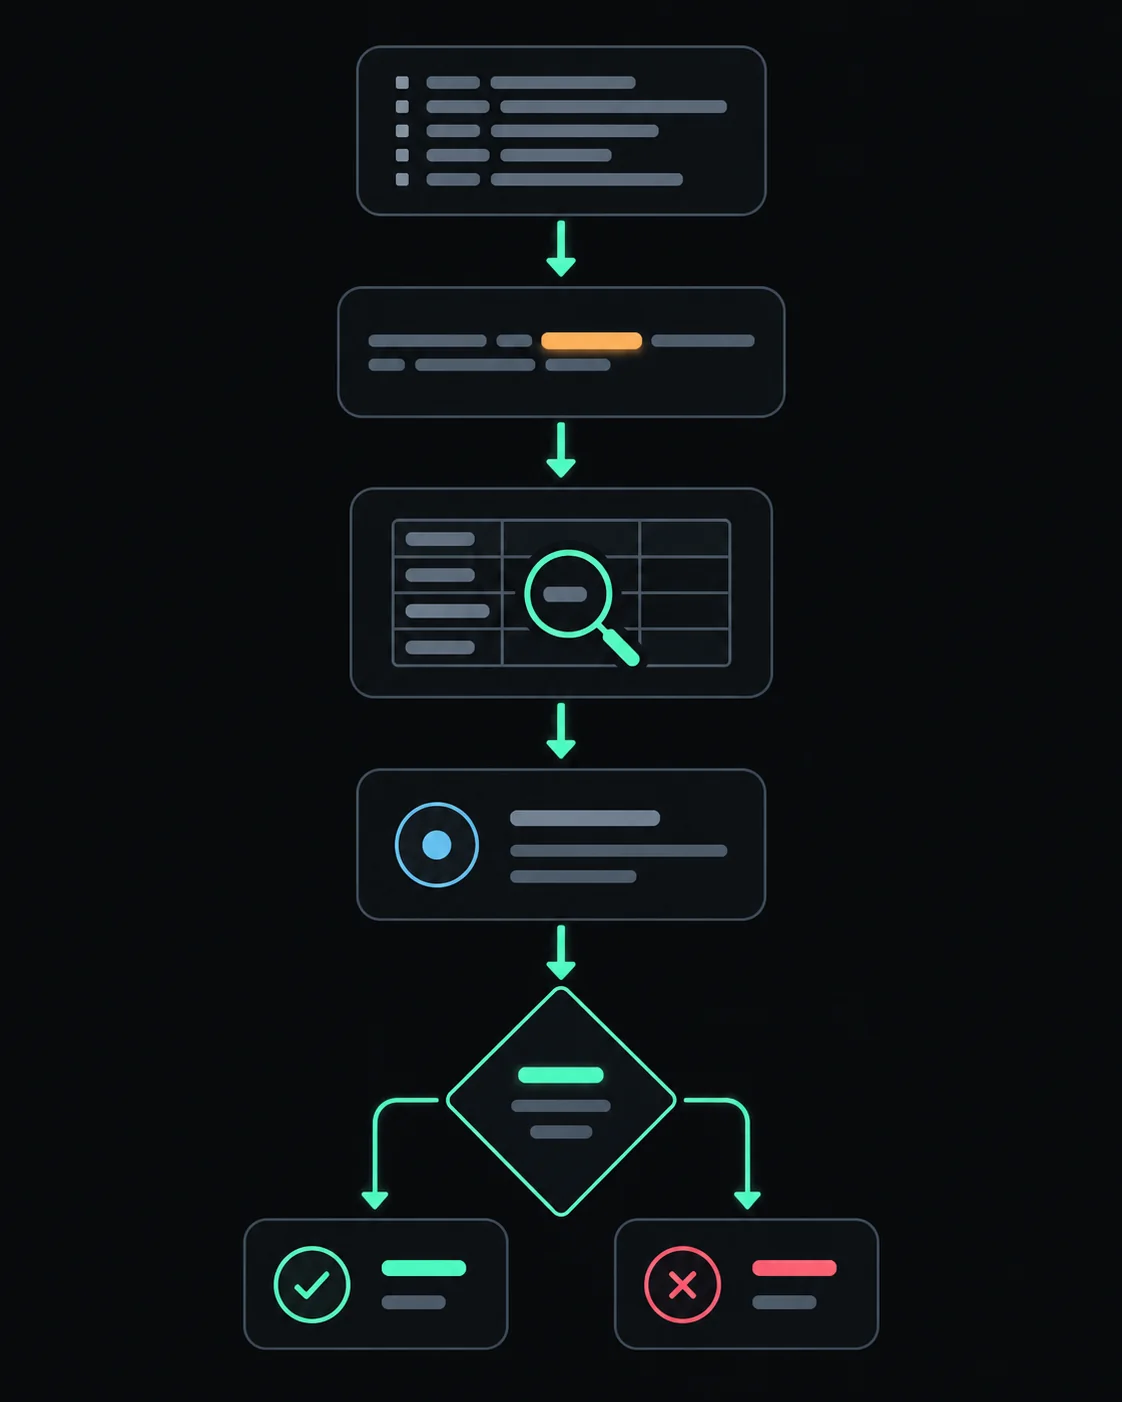
На маршруте те же шаги идут сверху вниз: строка из лога, выделенный в ней токен, строка справочника с владельцем и назначением, решение пустить или закрыть и переход на детальную страницу бота. Нижние два шага зависят от верхних, поэтому начинать всегда с точного токена.
Сначала этих ботов надо где-то увидеть. Два рабочих места это журнал доступа сервера, где строка User-Agent видна напрямую, и отчёты переходов в Яндекс.Метрике, где заметны переходы от ChatGPT, Perplexity и Claude. Лог полезнее для точного опознания: в нём видна полная строка User-Agent, из которой вы берёте токен для поиска по справочнику. Метрика отвечает на другой вопрос — приводят ли AI-интерфейсы живых людей, а не только обходят ли вас краулеры. Два источника закрывают две разные задачи, и смотреть стоит в оба.
Прежде чем закрывать бота, проверьте, не закрыт ли он уже случайно. Подставьте нужный User-Agent, например GPTBot, в инструмент проверки robots.txt: в отчёте Google Search Console, в Bing Webmaster Tools или во внешнем валидаторе. Это важно вот почему. На примере условного аудита: приходите на сайт клиента и обнаруживаете, что GPTBot и ClaudeBot заблокированы пресетом Cloudflare, который никто не включал осознанно и давно не проверял. Снимаете блок, и обращения этих ботов возвращаются. Готовые пресеты и правила WAF умеют закрывать AI-ботов по умолчанию, поэтому проверка робота стоит пяти минут.
Дальше у вас развилка. За полным рецептом robots.txt под конкретного бота и за пошаговой проверкой подлинности по IP идите на детальные страницы отдельных ботов и в соседние материалы. Общая точка входа в тему это обзорная страница хаба об AI-ботах, откуда открываются страницы каждого краулера.
Если хочется не вручную разбирать логи, а сразу видеть, какие AI-боты и AI-переходы приходят на сайт, Zrok определяет их через JS-сниппет. Проверить готовность сайта к AI-агентам можно бесплатно в Agent Check.