Как проверить и посмотреть robots.txt валидаторами, анализом и доступом AI-ботов

Коротко: robots.txt общедоступен и лежит в корне хоста, открывается по адресу вида домен/robots.txt, а проверяют его валидаторами синтаксиса, инструментами анализа и панелями вебмастеров. Ниже — короткий ответ под каждую частую ситуацию и переход к подробному разбору.
Все разделы статьиОткрыть содержание
Проверить robots.txt значит открыть файл по адресу в браузере, сверить его с требованиями стандарта, прогнать через валидатор и панель вебмастера и прочитать, что в нём написано про AI-ботов. Файл публичный, лежит в корне хоста, и чаще всего вопрос не в том, где он, а в том, работает ли правило так, как вы задумали.
Редакция Zrok
Создано · Обновлено
Как открыть robots.txt любого сайта по адресу /robots.txt
Перед пошаговым разбором стоит увидеть, как устроена проверка целиком.
Допишите к адресу сайта /robots.txt и откройте в браузере — получится адрес вида https://site.ru/robots.txt. Так смотрят и свой файл, и чужой. Это чтение публичного файла, а не обход защиты, поэтому законно и безопасно.
По стандарту файл должен лежать строго в корне сервиса и называться строчными буквами. Нормальный ответ — это текст с директивами. Тревожный ответ — код 404 или обычная HTML-страница вместо правил: значит файла в корне нет либо сервер отдаёт не то.
«The rules MUST be accessible in a file named "/robots.txt" (all lowercase) in the top-level path of the service.»RFC 9309, Robots Exclusion Protocol · раздел 2.3 Access Method · проверено 21.10.2026
Что это значит: ищите файл только в корне и только по имени /robots.txt строчными буквами. То же подтверждает документация Google: один файл на хост, корень, кодировка UTF-8.
Отсюда неочевидное: правила действуют только на тот хост, протокол и порт, где лежит файл. У каждого поддомена свой robots.txt в его корне, в подпапках краулеры файл не ищут. Проверяете поддомен — открывайте его адрес, а не корень основного домена.
Удобно видеть весь путь проверки целиком.
Проверка синтаксиса валидаторами и инструментами анализа
Когда свой файл открывается и отдаёт текст, следующий шаг — убедиться, что в нём нет опечаток и структурных проблем. Начните с базовых требований, которые проверяются глазами: файл в корне хоста, кодировка UTF-8, имя строчными буквами, одна директива в строке. Отдельно держите в голове регистр. Имя директивы регистронезависимо, а вот значение пути чувствительно к регистру, поэтому /Catalog/ и /catalog/ для краулера это разные пути.
Важно, как инструменты и боты ведут себя с мусором. Невалидные строки Google игнорирует. А если вместо правил отдаётся HTML-страница, краулер разбирает её как получится и вытаскивает похожее на правила. Поэтому проверяют не наличие файла, а фактический ответ сервера.
Публичные онлайн-валидаторы закрывают первый слой: показывают структуру групп, подсвечивают неизвестные директивы и опечатки. Дальше начинается интерпретация конкретного поисковика: валидатор не знает, как ваш робот разберёт спорное правило на реальном URL. Это уже работа панелей вебмастеров.
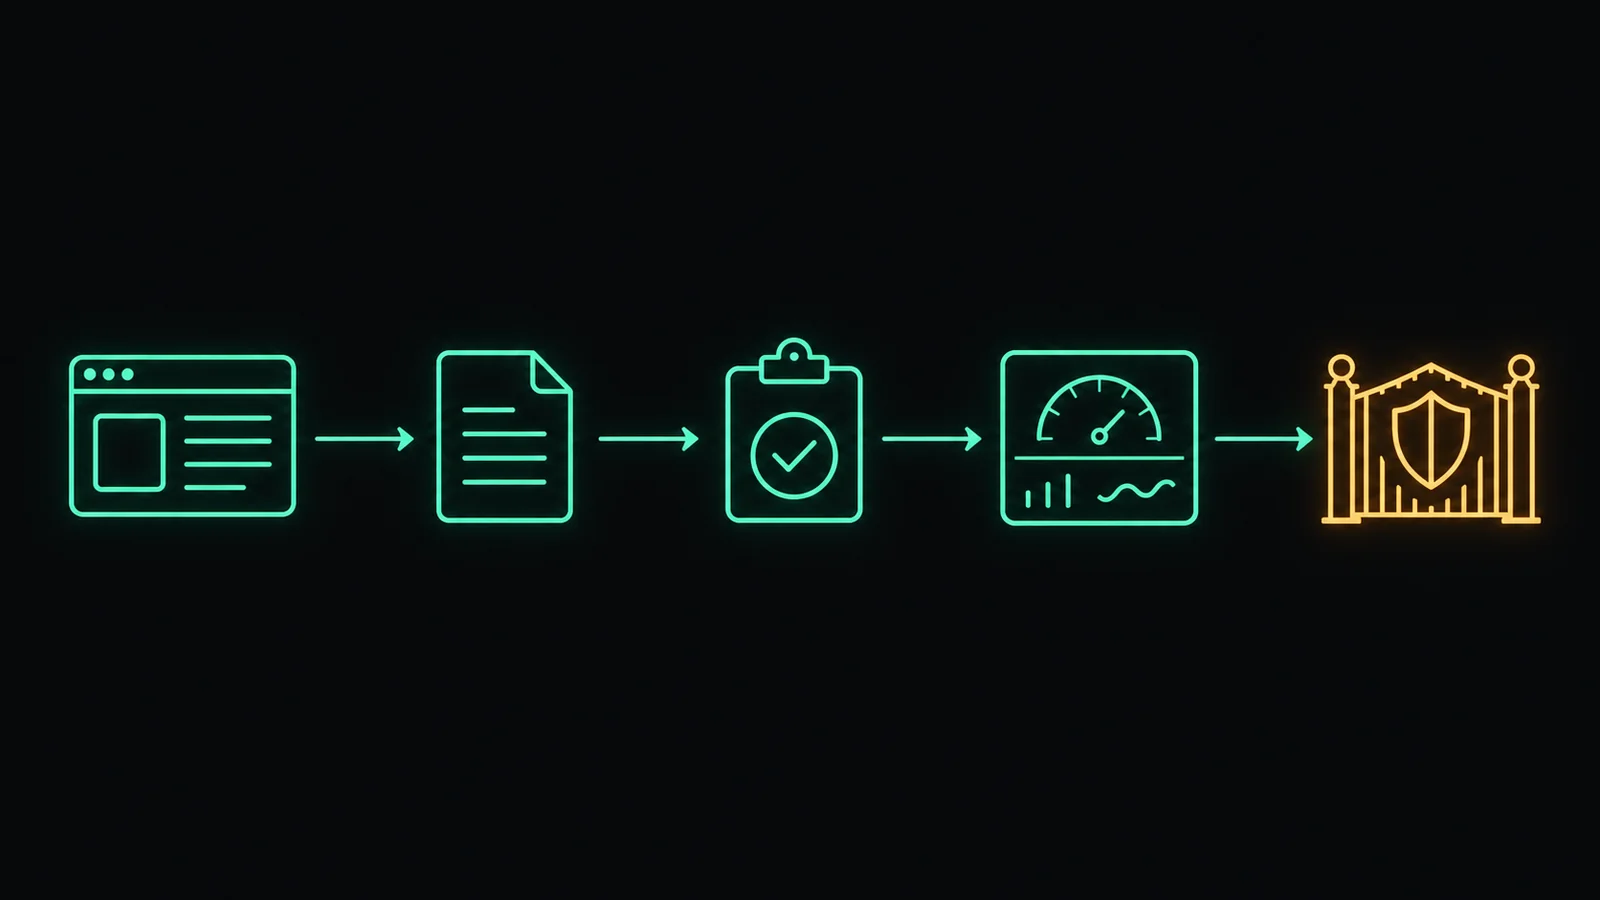
Проверка в Яндекс Вебмастере и Google Search Console
Валидатор отвечает на вопрос, корректны ли строки. Панель вебмастера отвечает на более важный: применится ли правило к нужному URL так, как поймёт его сам поисковик. Это проверка только на своих подтверждённых ресурсах.
Анализ robots.txt в Яндекс Вебмастере
В Яндекс Вебмастере это раздел Инструменты, пункт Анализ robots.txt. Он разбирает директивы, показывает ошибки и противоречия и хранит историю версий. Главное для проверки — блок «Доступ к страницам»: вписываете конкретный URL и видите, открыт он для индексирования или закрыт. Тонкость: секции для робота Яндекса инструмент проверяет по правилам Яндекса, а остальные — по стандарту.
Отчёт robots.txt в Google Search Console
В Google Search Console аналогичную задачу решает отчёт robots.txt. Он показывает статус загрузки (Fetched или Not Fetched с кодом 404), размер файла и список проблем. Здесь принципиально различать два типа записей: ошибки блокируют применение правила, а предупреждения не мешают ему работать. Отчёт доступен только для ресурса уровня домена и заменил старый robots.txt Tester, который выведен из эксплуатации.
«Errors prevent a rule from being used. Warnings do not prevent a rule from being used.»Google Search Console Help, robots.txt report · раздел Issues · проверено 21.10.2026
Что это значит: если в отчёте висит ошибка, именно она ломает правило, и чинить надо её. Предупреждение можно учесть позже — оно не отключает строку.
Как проверить конкретный URL
Проверка доступа для одного URL
3 шагаПорядок, после которого видно, что поисковик думает о конкретном адресе.
Откройте Анализ robots.txt в Яндекс Вебмастере
В блоке «Доступ к страницам» вставьте URL и посмотрите вердикт: страница открыта или недоступна для индексирования.
Откройте отчёт robots.txt в Google Search Console
Посмотрите статус загрузки файла, его размер и список проблем. Отделите ошибки от предупреждений.
Сверьте результат с валидатором
Если панель и валидатор расходятся, доверяйте панели: она показывает интерпретацию робота, а не только формальную корректность строк.
Результат: вы знаете не «файл без ошибок», а «этот URL для этого робота открыт или закрыт».
| Инструмент | Что показывает | Чего не показывает | Для чьего сайта |
|---|---|---|---|
| Просмотр в браузере | Содержимое файла и факт ответа сервера. | Интерпретацию правил и результат для URL. | Любого |
| Публичный валидатор | Синтаксис, структуру групп, опечатки. | Как разберёт правило конкретный поисковик. | Любого |
| Анализ robots.txt (Яндекс) | Разбор директив и доступ к конкретному URL. | Поведение не-Яндекс роботов вне стандарта. | Своего |
| Отчёт robots.txt (GSC) | Статус загрузки, размер, ошибки и предупреждения. | Правила для хостов вне ресурса домена. | Своего |
Как понять, разрешены или запрещены AI-боты (GPTBot, ClaudeBot, CCBot)
С обычными поисковиками всё привычно, а вот AI-краулеры часто остаются слепой зоной. Думать только о Googlebot уже мало. У AI-платформ свои отдельные имена ботов, и общее правило User-agent: * их не описывает. Поэтому доступ для них читают по отдельным группам.
Какие токены AI-ботов искать
Откройте файл и ищите строки User-agent с именами: GPTBot и OAI-SearchBot (OpenAI), ClaudeBot (Anthropic), CCBot (Common Crawl, представляется как CCBot/2.0) и Google-Extended (Google). Токенов больше, но эти встречаются чаще всего. Имена сверяйте с документацией вендора: это имя-токен в тексте, а не IP-адрес, и вендоры их со временем меняют. Проверка подлинности бота по IP и обратному DNS — отдельная тема. Здесь мы читаем только файл.
Чем отличается обучающий краулер от поискового бота
Ключевое различие: один токен может быть открыт, а другой закрыт, и проверять нужно каждый по отдельности. У OpenAI GPTBot собирает контент для обучения моделей, а OAI-SearchBot отвечает за показ сайта в поиске ChatGPT. Это два независимых решения: можно закрыть обучение, но остаться в поиске. CCBot тоже стоит особняком — его архив часто используют для сбора данных под обучение ИИ.
Почему отсутствие Disallow означает открытый доступ
Правило чтения простое. Если у токена нет строки Disallow, закрывающей нужный путь, доступ открыт. По стандарту при отсутствии совпадающего правила URL считается разрешённым, то есть отсутствие запрета — это уже разрешение. Вот как выглядит файл, где один бот закрыт, а другой оставлен в поиске.
User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: CCBot
Disallow: /

User-agent: ClaudeBot
Disallow: /GPTBot, CCBot и ClaudeBot, но сайт остаётся в поиске ChatGPT через OAI-SearchBot. Пути иллюстративны, имена ботов сверьте с документацией вендора.При этом корректная строка — это просьба: соблюдение robots.txt у AI-компаний добровольное, и файл не гарантирует, что бот подчинится.
Если проверка показала, что AI-боты сейчас открыты, а вы хотите их закрыть, как закрыть доступ AI-ботам — в отдельной статье разобрано, как это сделать и что при этом реально работает.
Типичные ошибки, из-за которых правило не работает
Правило на вид корректное, а бот всё равно заходит или нужная страница закрыта. Чаще всего причина в одном из пунктов ниже.
Правило не в том блоке User-agent
Самая частая причина для AI-ботов: запрет стоит в группе User-agent: *, а у AI-краулера своё имя. Бот со своей группой читает только её и общую со звёздочкой не складывает. Нет отдельной группы для GPTBot или ClaudeBot — значит их это правило не касается.
Конфликт Allow и Disallow по длине совпадения
Когда на один URL подходят и Allow, и Disallow, спор решает не порядок строк, а длина совпадения.
User-agent: *
Disallow: /catalog/
Allow: /catalog/public//catalog/public/ выигрывает Allow: его совпадение длиннее. Остальная часть /catalog/ остаётся закрытой.«The most specific match found MUST be used. The most specific match is the match that has the most octets.»RFC 9309, Robots Exclusion Protocol · раздел 2.2.2 The Allow and Disallow Lines · проверено 21.10.2026
Что это значит: возьмите спорный URL, найдите подходящие Allow и Disallow и сравните, чьё совпадение длиннее по числу октетов. При равной длине выигрывает Allow.
Неверный путь или регистр значения
Значение пути чувствительно к регистру, а путь должен начинаться со слеша. Лишняя или забытая звёздочка, неверный регистр буквы, пропущенный слеш — и совпадение не срабатывает. Если правило молчит, первым делом посимвольно сверьте путь в правиле с реальным адресом страницы.
Кэш и неверный код ответа
Свежая правка срабатывает не мгновенно: Google обычно кэширует robots.txt до 24 часов. А если файл отдаётся не из корня или с неверным HTTP-кодом, правил для краулера фактически нет. Google трактует все ответы 4xx, кроме 429, как отсутствие валидного robots.txt, то есть считает, что ограничений на обход нет.
Лимит разбора и граница добровольного протокола
Краулеры обязаны разбирать файл размером не менее 500 КиБ. Содержимое сверх лимита может игнорироваться, поэтому важные правила держат ближе к началу. И последнее. Даже идеально составленное правило — это просьба. robots.txt добровольный протокол и строгого запрета не обеспечивает.
Разбор ситуаций читателей
Задать вопросРазбор ситуации
Готовлю страницу под AI-поиск, с чего начать проверку
Практик описывает первый шаг перед GEO-работой: не ясно, что проверять раньше — контент, разметку или доступность.
Ответ редакции ZrokНачинайте с доступности, а не с оформления. Сначала robots.txt должен пропускать нужные AI-краулеры, затем страница должна быть в карте сайта по каноническому URL. Если файл блокирует бота, страница для цитирования невидима — это и чинят прежде, чем браться за разметку и тексты.
Разбор ситуации
GPTBot и ClaudeBot оказались закрыты, хотя их никто не закрывал
При аудите чужого сайта обнаружили, что AI-боты заблокированы не намеренно, а пресетом Cloudflare, который никто не пересматривал.
Ответ редакции ZrokТак бывает: часть платформ и CDN добавляет блокировку AI-ботов по умолчанию, и robots.txt меняется без ведома владельца. По наблюдению автора, после того как лишний запрет убрали, AI-реферальный трафик у клиента заметно вырос. Проверять стоит именно сам файл: он покажет, какие группы и запреты там реально стоят, кем бы они ни были добавлены.
Разбор ситуации
Хостинг посоветовал закрыть ботов, а совет оказался вредным
Владелец сайта рассказывает, как провайдер порекомендовал настроить в Cloudflare блокировку не тех ботов; ошибку заметили вовремя.
Ответ редакции ZrokАвтор честно отмечает, что обычный владелец сайта мог бы не распознать вредный совет и принять его за экспертный. Отсюда общий вывод: после любой правки доступа откройте свой /robots.txt и прочитайте, какие группы и запреты там оказались. Регулярная сверка дешевле, чем молча потерять видимость.
Вопросы практиков
ДенисЧто надёжнее для строгого запрета — robots.txt или блокировка на сервере?
Для строгого запрета надёжнее серверный уровень. robots.txt привычен и поддерживается крупными AI-компаниями, но по сути это мягкая просьба, которую можно проигнорировать. Блокировка через сервер, CDN или WAF ставит технический барьер, но требует больше усилий и постоянного обслуживания. Выбор зависит от того, насколько критичен именно жёсткий запрет.
МаринаНужен ли llms.txt, если доступ уже управляется через robots.txt?
Сейчас это не приоритет. llms.txt — предложенный стандарт, но на момент проверки ни один крупный провайдер LLM официально его не поддерживает как инструмент управления доступом. Файлом, который реально влияет на обход, остаётся robots.txt; его и проверяйте в первую очередь.
АртёмЕсли я поставил корректный Disallow, бот точно перестанет заходить?
Гарантии нет. Соблюдение robots.txt добровольное: корректная строка сообщает о запрете, но не закрывает доступ физически. Факт реальных заходов проверяют уже по логам сервера и по IP-адресам бота, а не по самому файлу — это отдельная тема за рамками проверки robots.txt.
Короткий чек-лист проверки
- Файл открывается по адресу
домен/robots.txtи отдаёт текст директив, а не 404 или HTML. - Расположение в корне хоста, кодировка UTF-8, имя строчными буквами, одна директива в строке, регистр значения пути учтён.
- Синтаксис прогнан через валидатор и инструмент анализа.
- Нужный URL проверен в Анализе robots.txt и/или в отчёте robots.txt Google Search Console, ошибки отделены от предупреждений.
- Найдены и прочитаны группы AI-токенов (
GPTBot,OAI-SearchBot,ClaudeBot,CCBot,Google-Extended) — доступ открыт или закрыт. - Проверены типичные причины сбоя: блок
User-agent, длина совпаденияAllowиDisallow, путь и регистр, кэш, HTTP-код.
Источники и дата проверки
- RFC 9309: Robots Exclusion ProtocolИмя и расположение файла, совпадение правил, лимит разбора.
- Google: How Google interprets the robots.txt specificationКоды ответа, кэш, регистр, выбор группы.
- Google Search Central: Create and submit a robots.txt fileРазмещение и кодировка файла.
- Google Search Console Help: robots.txt reportОтчёт, ошибки и предупреждения.
- Яндекс Вебмастер: Анализ robots.txtРазбор директив и доступ к URL.
- OpenAI: Overview of OpenAI CrawlersТокены GPTBot и OAI-SearchBot.
- Anthropic: Does Anthropic crawl data from the webТокен ClaudeBot.
- Common Crawl: CCBotТокен CCBot/2.0.
Источники проверены .