Как изменить robots.txt в Tilda и добавить правила для краулеров и AI-ботов

Коротко: файл robots.txt на Tilda уже создан платформой и правится через Настройки сайта → SEO, а не через FTP. Кастомные директивы добавляют в ручном режиме, а результат проверяют по адресу сайт/robots.txt.
Все разделы статьиОткрыть содержание
robots.txt на Tilda редактируется через настройки конструктора, а доступа к файлу по FTP здесь нет. Файл уже существует и уже отдаётся роботам, поэтому вся работа идёт через интерфейс платформы.
Редакция Zrok
Создано · Обновлено
Где Tilda хранит robots.txt и что в нём можно менять
robots.txt на Tilda устроен иначе, чем на обычном хостинге, и это видно с первого открытия файла.
Tilda генерирует robots.txt и sitemap.xml сама, без вашего участия. Чтобы увидеть свой файл, допишите /robots.txt к адресу сайта и откройте в браузере, и платформа отдаст то, что сформировала из настроек ваших страниц.
Стандарт robots.txt (RFC 9309) требует, чтобы правила лежали в корне сервиса в файле с именем /robots.txt строчными буквами. На адресе Tilda это условие уже выполнено за вас: файл отдаётся из корня и под нужным именем.
Базовый файл Tilda собирает автоматически из настроек страниц: что закрыто от индексации, что открыто, где лежит карта сайта.
Откройте свой сайт/robots.txt и посмотрите, что там уже есть: директивы для поисковых роботов и ссылку на sitemap.xml. Это зона, которую платформа ведёт за вас, а ваши правки лягут поверх неё.
Путь к настройкам простой: Мои сайты, затем ваш сайт, затем Настройки сайта. Прямого доступа к коду файла, как на обычном хостинге, здесь нет ни по FTP, ни в редакторе страниц. Всё, что можно поменять, собрано в разделе SEO.
Как отредактировать robots.txt в настройках Tilda
Переключатель живёт в Настройки сайта → SEO → Редактирование robots.txt, и работу этого раздела Tilda описывает в своей справке по поисковой оптимизации. По умолчанию стоит автоматический режим; чтобы править файл руками, включите «Ручное управление».
Путь к переключателю короткий, вот он по шагам.
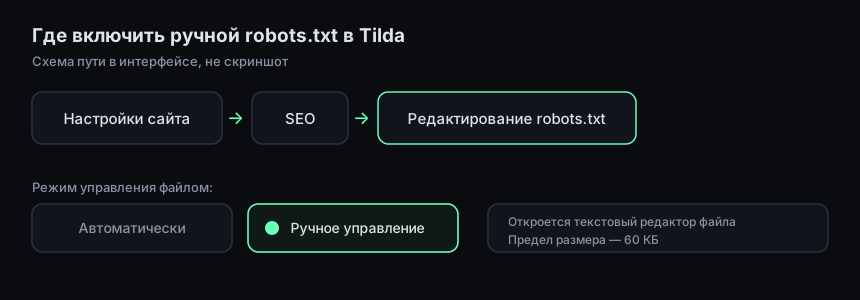
Теперь впишите нужные директивы прямо в редактор и нажмите «Сохранить», и изменения применятся к файлу сразу. Держите в голове один предел: максимальный размер файла 60 КБ. Для обычного сайта это много, но если вы генерируете длинные списки Disallow вручную, в потолок можно упереться.
Важный момент, который стоит решить до переключения: после перехода на ручной режим Tilda перестаёт сама добавлять в файл настройки индексации страниц. Если раньше вы ставили на отдельной странице запрет индексации и он попадал в robots.txt автоматически, то теперь такие правки придётся вносить руками. Это осознанный компромисс, а не сбой платформы.
Поэтому заранее прикиньте, полагаетесь ли вы на авто-синхронизацию настроек отдельных страниц: если их много, возможно, хватит обходных полей без ручного режима.
Ручной режим не финальный: вернуться к файлу и поправить его можно сколько угодно раз.
При ручной правке сохраните то, что платформа уже положила в файл (ссылку на sitemap.xml и нужные правила), и допишите свои группы ниже, не затирая остальное.
А если нужного поля в Tilda просто нет?
Что делать, если нужных правил в Tilda нет
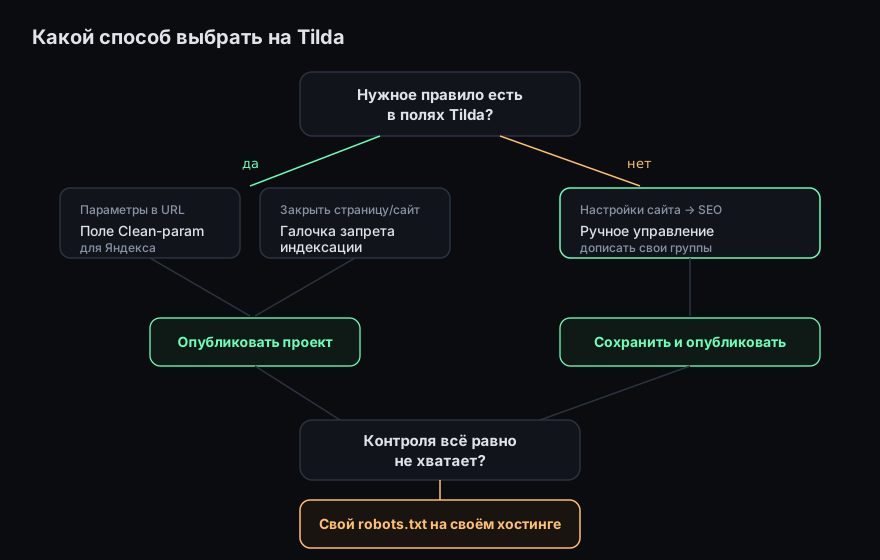
Иногда ручной файл избыточен или кажется рискованным. Тогда выбор идёт между тремя готовыми инструментами Tilda и одним радикальным, а сравнивать их удобнее по двум признакам: сколько контроля они дают и чего стоят.
Галочка запрета индексации
Самая частая причина, почему свежий сайт на Tilda не появляется в поиске, это включённая галочка «Запрет индексации» в настройках. Пока она стоит, платформа закрывает сайт прямо в robots.txt.
Снимите галочку в настройках сайта и опубликуйте проект заново: файл пересоберётся, и сайт откроется роботам.
Про эту галочку забывают чаще всего.
Поле Clean-param для Яндекса
Для мусорных URL с GET-параметрами (utm-метки, фильтры) есть отдельное поле: Настройки сайта → SEO → Управление Clean-param в robots.txt. Впишите первый параметр после знака «?», каждый с новой строки, и опубликуйте проект.
Clean-param — это директива робота Яндекса для динамических параметров, которые не меняют содержимое страницы. В стандарте RFC 9309 её нет, то есть на другие поисковики она не распространяется. Для Google и прочих параметры закрывают иначе, и это стоит помнить, если трафик у вас не только из Яндекса.
У поля есть реальный предел около 500 символов. Один из владельцев, настраивая очистку, поймал ошибку «Некорректный формат директивы Clean-param» именно из-за этого ограничения и не смог закрыть все параметрические страницы одним полем. Если параметров много, разложите их аккуратнее или комбинируйте с ручным режимом.
Напрашивается мысль: а не прописать ли просто Disallow: /?, чтобы отрезать всё после вопросительного знака? Для параметрических URL на Tilda это хуже. Disallow закрывает страницы от индексации целиком, и если под параметрами у вас фильтры каталога, вы теряете поведенческие сигналы с этих страниц. Clean-param же склеивает дубли, не выкидывая страницу из индекса.
Свой robots.txt на собственном хостинге
Если возможностей конструктора всё равно не хватает, остаётся радикальный путь, свой полноценный robots.txt на собственном хостинге. По стандарту файл лежит в корне, и там вы прописываете любые директивы без оглядки на поля Tilda. Это полный контроль, но ценой выхода за рамки платформы.
Для этого нужен экспорт проекта или перенос сайта на свой хостинг, где у вас есть доступ к корню.
Чтобы выбрать осознанно, сопоставьте все четыре способа по одному набору признаков: что инструмент делает, когда он уместен и где его предел.
| Способ | Что делает | Когда подходит | Ограничение |
|---|---|---|---|
| Ручное редактирование robots.txt | Любые директивы руками в редакторе | Нужны правила, которых нет в полях | Лимит 60 КБ; авто-синхронизация настроек страниц отключается |
| Поле Clean-param | Склеивает URL с GET-параметрами для Яндекса | Мусорные параметрические URL, трафик из Яндекса | Около 500 символов; только робот Яндекса, нет в RFC 9309 |
| Галочка запрета индексации | Закрывает страницу или весь сайт | Надо быстро закрыть или открыть индексацию | Грубый инструмент: страница уходит из индекса целиком |
| Свой robots.txt на хостинге | Полный контроль над файлом в корне | Конструктора не хватает | Нужен экспорт и выход за рамки Tilda |
Общее правило простое: берите самый лёгкий способ, который всё ещё даёт нужный уровень контроля. Для одной utm-метки хватит поля Clean-param, а ради сложных правил под AI-ботов понадобится ручной режим.
Как раз про AI-ботов дальше.
Добавляем правила для AI-ботов GPTBot и ClaudeBot на Tilda
В ручном режиме в robots.txt на Tilda можно добавить и группы для AI-краулеров. Каждая группа — это строка User-agent с именем бота и правило доступа, например Disallow: /, если закрываем сайт целиком.
Обучающий краулер OpenAI представляется токеном GPTBot, именно он собирает контент для обучения моделей, что OpenAI описывает в документации по своим ботам. Отдельно работают OAI-SearchBot (поиск внутри ChatGPT) и ChatGPT-User (заход по конкретному запросу пользователя). Это разные токены, и доступ к каждому вы регулируете в robots.txt независимо.
У Anthropic веб-краулер называется ClaudeBot и закрывается правилом User-agent: ClaudeBot с Disallow: /, о чём Anthropic пишет в своей справке. Рядом существуют Claude-User и Claude-SearchBot, тоже отдельные токены со своим назначением.
Чтобы закрыть обучающих краулеров, но оставить дорогу поисковым, в ручной файл добавляют такие группы:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /
Смысл набора в том, что GPTBot и ClaudeBot вы закрываете, а поисковых OAI-SearchBot и Claude-SearchBot оставляете открытыми, для них Disallow просто не добавляете.
Поисковые токены отвечают за то, попадёт ли сайт в ответы AI-поиска. Если вы хотите, чтобы вас находили в ChatGPT, но не отдавать контент на обучение, именно разница между обучающим и поисковым токеном решает эту задачу.
И вот что важно помнить: robots.txt — это просьба, а не технический замок. Добросовестные краулеры её уважают, но часть ботов может правила проигнорировать. Жёсткий запрет делается на уровне сервера, а на Tilda такого уровня без экспорта сайта нет. Поэтому добавление группы не гарантирует, что ваш контент исчезнет из AI-выдачи.
Копируйте в файл только те группы, которые действительно хотите применить: лишние строки потом сложнее отслеживать.
Если не до конца понятно, что именно делают строки User-agent, Disallow и Allow, общий разбор синтаксиса есть в статье о составлении robots.txt, здесь мы не повторяем его, а применяем к Tilda.
Наборы токенов у OpenAI и Anthropic со временем меняются, поэтому перед применением сверяйте их с официальной документацией.
Осталось убедиться, что всё применилось.
Как проверить, что изменения применились
Проще всего открыть сайт/robots.txt в браузере после публикации и глазами увидеть реально отданный файл.
Дальше прогоните файл через инструмент «Анализ robots.txt» в Яндекс.Вебмастере и через robots-тестер Google. Они показывают, какие правила видит робот для конкретного адреса и конкретного бота, и это надёжнее, чем читать файл на глаз, потому что инструменты учитывают правило самого длинного совпадения.
Там же удобно разобрать частый вопрос про фильтры. Если под параметрами у вас набор свойств вида property[1], property[2] и так далее, в Clean-param достаточно указать один property, под правило подпадут все варианты.
Перепроверяйте файл после каждой правки, а не один раз в начале.
В выводе тестера смотрите на статус для заданного URL и бота: разрешён обход или заблокирован. Если ждали запрет, а видите «разрешено», значит, директива не сработала, проверьте имя токена и отступы в группе.
Короткий чек-лист, прежде чем считать задачу закрытой.
- файл открывается по адресу
сайт/robots.txtи содержит ваши правки; - проект опубликован заново после изменений;
- нужная директива видна в «Анализе robots.txt» и robots-тестере;
- имена ботов совпадают с документацией OpenAI и Anthropic.
Когда всё сходится, сохраните проверенный файл у себя как опорный: при следующих правках будет с чем сравнить.
Остались короткие вопросы
После настройки Clean-param остались ссылки вида сайт/?...&etext. Что с ними делать?
Добавьте параметр etext в то же поле Clean-param, он уберёт основную массу таких адресов. Единичные остаточные ссылки можно оставить: на общую картину индексации они почти не влияют.
Источники
- Справка Tilda по поисковой оптимизации, где конструктор хранит robots.txt: help-ru.tilda.cc/search-engine (проверено 21.10.2026).
- Справка Tilda по полю Clean-param: tilda.cc/ru/answers/a/clean-param (проверено 21.10.2026).
- Документация OpenAI по краулерам GPTBot, OAI-SearchBot и ChatGPT-User: platform.openai.com/docs/bots (проверено 21.10.2026).
- Справка Anthropic о краулере ClaudeBot: support.anthropic.com (проверено 21.10.2026).
- Стандарт robots.txt RFC 9309: rfc-editor.org (проверено 21.10.2026).
- Справка Яндекса по директиве Clean-param: yandex.ru (проверено 21.10.2026).