Как составить robots.txt с нуля

Коротко: создайте текстовый файл robots.txt в кодировке UTF-8, положите его в корень сайта и опишите группами User-agent, кому и какие разделы разрешено обходить. Ниже — короткий ответ под каждую частую ситуацию и переход к подробному разбору.
Все разделы статьиОткрыть содержание
robots.txt — это текстовый файл с правилами обхода, который лежит в корне сайта и подсказывает поисковым и AI-краулерам, какие разделы читать, а какие обходить стороной. Если такого файла у вас ещё нет или в нём стоят чужие строки и непонятный пустой Disallow, начинать стоит с самого файла: создать его и положить туда, где краулеры его найдут.
Редакция Zrok
Создано · Обновлено
Где лежит robots.txt и как его создать, подключить и выдать права доступа
robots.txt лежит в корне и срабатывает ещё до обхода страниц.
Дальше остаётся положить файл в нужное место и описать в нём группы.
Собрать файл можно руками за пару минут. Это обычный текст, а не программа, и в простом случае ему хватает нескольких строк, чтобы работать.
Как создать файл
Откройте любой простой текстовый редактор, впишите нужные директивы и сохраните результат именно как robots.txt — имя строчными буквами, кодировка UTF-8. В Windows у сохранения есть ловушка: Блокнот может добавить скрытое расширение, и вместо robots.txt на диске окажется robots.txt.txt. Проверьте реальное имя файла и не форматируйте текст в Word — краулеру нужен чистый текст без лишней разметки.
«The rules MUST be accessible in a file named "/robots.txt" (all lowercase) in the top-level path of the service.»RFC 9309, Robots Exclusion Protocol · раздел 2.3 Access Method · проверено 21.10.2026
Что это значит: файл называют строго /robots.txt строчными буквами, кладут в корень сервиса и отдают в UTF-8, иначе краулер его не прочитает.
Куда его положить
Файл кладут строго в корень сервиса, чтобы он открывался по адресу вида https://site.ru/robots.txt. На один хост полагается один такой файл с именем строчными буквами. Проверить размещение можно прямо в браузере: откройте этот адрес. Если по нему пусто или сервер отдаёт 404, значит для краулера правил пока нет и он считает, что обходить можно всё.
Как подключить файл
На обычном хостинге файл попадает в корень загрузкой: по FTP (например, через FileZilla) или через файловый менеджер в панели управления. Корневая папка — та, где лежит главная страница, часто это public_html, а не вложенный каталог. На CMS бывает иначе: файла в корне может не быть, его отдаёт сама система. Этот случай разберём ниже на примере WordPress.
Вот как это выглядит в файловой структуре и в адресной строке браузера.
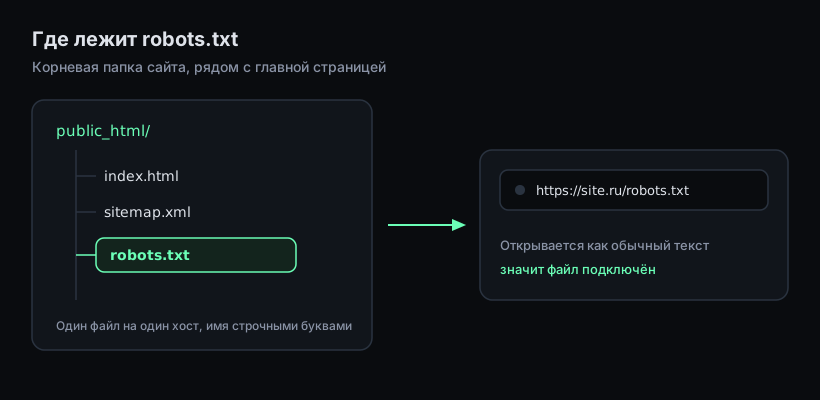
Рабочий адрес всегда короткий, сразу после домена, а тот же файл в подпапке по /robots.txt уже не откроется.
Какие нужны права доступа
Под правами доступа здесь понимают простую вещь: файл должен быть публично доступен и открываться по своему адресу, а не быть спрятан или закрыт от запроса. По адресу он должен показываться как текст, а не скачиваться или отдавать ошибку. Речь именно о доступности, а не о конкретном числе прав вроде chmod: точного значения ни стандарт, ни документация вендоров не задают.
Здесь же возникает частый вопрос новичка: добавлять файл вручную или это сделает система. Если ваша CMS уже отдаёт виртуальный файл, его правят из админки; если нет — создают и загружают руками.
Структура файла и директивы User-agent, Disallow, Allow
Строки User-agent, Disallow и Allow в чужом файле выглядят пугающе, но логика у них простая. Файл состоит из групп, и каждая группа начинается со строки User-agent, которая адресует правила конкретному роботу или всем сразу. Робот находит свою группу, применяет только её правила, а остальные игнорирует. Пустая строка отделяет одну группу от другой.
| Строка | Что делает | На что обратить внимание |
|---|---|---|
| User-agent | Указывает, кому адресована группа правил. | Имя сравнивается без учёта регистра; нет своей группы — бот берёт группу со звёздочкой. |
| Disallow | Запрещает обход указанного пути. | Пустой Disallow не запрещает ничего; весь сайт закрывает только Disallow со слешом. |
| Allow | Разрешает обход указанного пути. | Нужен, чтобы открыть исключение внутри закрытого раздела. |
| Конфликт правил | Определяет, какое правило сработает. | Выигрывает самое длинное по числу символов совпадение, при равной длине — Allow. |
Строка User-agent и кому адресованы правила
Робот сравнивает своё имя (product token) с именами в строках User-agent без учёта регистра и подчиняется той группе, где он назван. Если собственной группы нет, он берёт группу User-agent: * как запасную — звёздочка означает «все остальные». При этом бот со своей группой читает только её и не складывает со звёздочкой, поэтому все нужные ему правила прописывают прямо в его группе.
Что делают Disallow и Allow
Disallow запрещает обход указанного пути, Allow — разрешает. На короткой паре строк это видно так: Disallow закрывает целый раздел, а Allow открывает внутри него нужное исключение. Путь считается от корня сайта.
User-agent: *
Disallow: /cart/
Allow: /cart/success/

User-agent: Yandex
Disallow:/cart/, но оставляет открытой /cart/success/. Пустой Disallow: во второй группе не запрещает ничего. Подставьте свои пути.Отсюда и ответ на частый страх «а не закрою ли я случайно весь сайт». Пустой Disallow без пути ничего не запрещает: запрещать нечего, и сайт остаётся открытым. Закрывает весь сайт только одна строка — Disallow: / со слешом.
Какое правило побеждает при конфликте
Когда на один и тот же URL подходят и Allow, и Disallow, применяется самое специфичное правило — то, у которого совпадение с адресом длиннее по числу символов. При равной длине выигрывает Allow.
«The most specific match found MUST be used. The most specific match is the match that has the most octets.»RFC 9309, Robots Exclusion Protocol · раздел 2.2.2 The Allow and Disallow Lines · проверено 21.10.2026
Что это значит: спор решают не порядком строк, а длиной совпадения. Возьмите URL, найдите подходящие Allow и Disallow и сравните, какое правило совпало с большим числом символов.
Спецсимволы * и $
В путях работают два спецсимвола. Звёздочка * заменяет любую последовательность символов, а доллар $ закрепляет конец адреса. Из-за них легко ошибиться: лишняя или забытая звёздочка меняет смысл правила. Например, Disallow: /*.pdf закрывает все PDF по любому пути, а точный путь без звёздочки закроет только один адрес. Один символ меняет охват всего правила, поэтому спорное правило лучше проверять инструментом в панели вебмастера, а не на глаз.
Важно помнить, что Disallow ограничивает обход, но не всегда убирает страницу из индекса — если вам нужно именно закрыть сайт или раздел от индексации, разберите этот случай отдельно, чтобы запрет действительно сработал.
Директива Sitemap и Clean-param и почему AI-боты её обычно не учитывают
В файле часто встречаются ещё две строки — Sitemap и Clean-param. Директива Sitemap указывает краулерам путь к XML-карте сайта, чтобы они быстрее находили страницы. Адрес в ней пишут полным, абсолютным: с протоколом и доменом целиком.
«The sitemap URL must be a fully-qualified URL; Google doesn't assume or check http/https/www.non-www alternates.»Google Search Central, Create and submit a robots.txt file · раздел про Sitemap · проверено 21.10.2026
Что это значит: пишите не /sitemap.xml, а полный адрес вида https://site.ru/sitemap.xml — Google не угадывает протокол и www за вас.
Путь из Sitemap должен реально существовать: если карты по адресу нет, робот получит ошибку, поэтому адрес проверяют до публикации.
Clean-param как директива Яндекса
Clean-param склеивает незначащие GET-параметры, чтобы робот Яндекса не обходил по многу раз одинаковые по сути страницы с разными метками в адресе. Синтаксис у неё такой:
User-agent: Yandex
Clean-param: p0[&p1&p2&..&pn] [path]ref или sort), а необязательное поле [path] задаёт префикс пути, для которого правило применяется.Робот Яндекса считает URL с такими параметрами и без них одной и той же страницей. Но у директивы есть важное ограничение: она не входит в стандарт RFC 9309 и специфична для Яндекса, поэтому Google и AI-боты её обычно не применяют. Для них дубли с параметрами решают другими средствами, а Clean-param универсальной строкой для всех краулеров не является.
Как адресовать правило конкретному краулеру, включая AI-ботов
Когда нужно открыть или закрыть именно одного бота, под него пишут отдельную группу. В ней идёт строка User-agent с именем бота и свои Disallow или Allow, а общее правило остаётся в группе со звёздочкой. Поскольку свою группу бот читает целиком и общие строки не берёт, правило для него прописывают полностью. Точное имя (product token) берут только из документации вендора, потому что токены со временем меняются и добавляются.
Устроено это как несколько независимых блоков в одном файле.
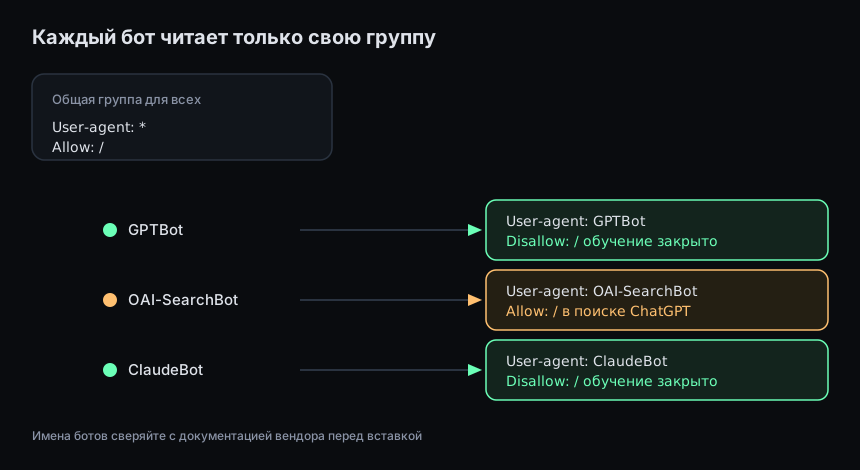
Поэтому закрыть одного бота можно, не трогая правила для остальных.
GPTBot и OAI-SearchBot (OpenAI)
У OpenAI два независимых токена robots.txt. GPTBot отвечает за сбор контента для обучения моделей, а OAI-SearchBot — за показ сайта в поиске ChatGPT. Настройки не связаны: можно закрыть обучение, но остаться в поиске ChatGPT.
«a webmaster can allow OAI-SearchBot in order to appear in search results while disallowing GPTBot to indicate that crawled content should not be used for training»OpenAI, Overview of OpenAI Crawlers · раздел про GPTBot и OAI-SearchBot · проверено 21.10.2026
Что это значит: это два решения по двум токенам — запрет GPTBot исключает контент из обучения, а показ в поиске ChatGPT решает отдельная группа OAI-SearchBot.
ClaudeBot (Anthropic)
Чтобы закрыть обучающий краулер Anthropic, в robots.txt добавляют группу User-agent: ClaudeBot с Disallow: /. Правило действует в пределах того хоста, где лежит файл, поэтому его повторяют на каждом поддомене, который вы хотите закрыть.
«Please do this for every subdomain that you wish to opt out from. An example of this is: User-agent: ClaudeBot Disallow: /»Anthropic, Does Anthropic crawl data from the web · пример блокировки ClaudeBot · проверено 21.10.2026
Что это значит: одной группы в корневом файле мало для сайта с поддоменами — правило Disallow: / для ClaudeBot дублируют в robots.txt каждого поддомена.
User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: ClaudeBot
Disallow: /Открыть или закрыть бота
Открыть бота значит дать разрешающее правило или просто не ставить запрета. Закрыть значит поставить Disallow на нужный путь или на весь сайт через Disallow: /. Здесь важна только механика адресации правила; как выстроить закрытие сайта от индексации, разобрано в соседней статье.
Готовые примеры robots.txt и онлайн-генераторы
Писать файл с нуля не обязательно: можно взять готовый базовый пример и подставить свой домен. За основу удобно брать пример из документации Google — группа для конкретного бота с запретом служебного пути, затем общая группа и строка Sitemap.
User-agent: Googlebot
Disallow: /nogooglebot/

User-agent: *
Allow: /

Sitemap: https://[ваш-домен]/sitemap.xmlЧитать такой пример полезно построчно. Первая группа адресована Googlebot и закрывает ему служебный путь /nogooglebot/ — это образец под конкретный сайт, а не обязательный набор для всех. Группа User-agent: * с Allow: / означает «остальным можно всё». Последняя строка Sitemap ведёт на вашу карту полным адресом. Готовый пример остаётся основой, а не финальным файлом.
Онлайн-генераторы
Если синтаксис ещё непривычен, помогает онлайн-генератор. Он собирает файл по шагам: спрашивает, какие разделы закрыть и какие боты интересуют, и формирует готовые группы и строку Sitemap. Итоговые пути всё равно просматривают глазами, ведь генератор исходит из ваших ответов, а не из структуры именно вашего сайта. И скопированный пример, и результат генератора стоит проверить перед загрузкой. Сама проверка файла разобрана отдельно.
robots.txt в WordPress и особый случай Tilda
На WordPress физического файла в корне часто нет, но robots.txt всё равно отдаётся по своему адресу. Дело в том, что файл формирует и отдаёт сама CMS по запросу — он виртуальный. Поэтому по FTP вы файла не увидите, а по адресу https://site.ru/robots.txt он открывается. Правят его SEO-плагинами: Yoast и аналоги дают в админке редактор robots.txt, изменения сохраняются в виртуальный файл, и именно оттуда в нём берутся строки групп вроде User-agent: Yandex.
Почему правки не применяются
Если в корне появляется физический файл robots.txt, он перекрывает виртуальный, и это частая причина, почему правки через плагин не видны. Обнаружить его можно по FTP: пока он лежит в корне, изменения из админки не применяются, а по адресу отдаётся старая строка. Выход один: править файл там, где он реально отдаётся, и оставить у него единственный источник правды.
Что обычно закрывают
На WordPress обычно закрывают служебные разделы: административные пути, внутренний поиск по сайту, личный кабинет и корзину, технические параметры фильтров. Это ориентир под конкретный сайт, а не единый шаблон: набор путей зависит от вашей структуры и от того, что именно вы не хотите пускать в обход.
Особый случай Tilda
Tilda стоит особняком: здесь свои ограничения на редактирование файла, и пошаговый обход этих ограничений вынесен в отдельный материал. Что бы вы ни настраивали, закончите одним действием — откройте свой адрес /robots.txt и убедитесь, что группы и строка Sitemap на месте.
Вопросы практиков
Задать вопросЗарегистрировал сайт на бесплатном хостинге, сайт работает, но не понимаю, как добавить на него файлы sitemap и robots.txt. Что делать?
Редакция ZrokСоздайте файл robots.txt в текстовом редакторе и загрузите в корневую папку сайта — через файловый менеджер в панели хостинга или по FTP. Карту sitemap.xml кладут туда же, в корень. Затем откройте адрес https://ваш-домен/robots.txt: если файл показывается как текст, он подключён.
Плагин сам добавил строки User-agent: Yandex и пустой Disallow:, а рядом ещё строка Host. Значит ли это, что файл закрыл весь сайт от индексации Яндексом?
Редакция ZrokНет, сайт открыт. Пустой Disallow: без пути ничего не запрещает — закрыл бы весь сайт только Disallow: / со слешом. Строка Host при этом устарела: Яндекс перестал её учитывать ещё в 2018 году, так что её можно спокойно убрать.
Спорю про звёздочку в конце пути: говорят, она подставляется автоматически, если не указан доллар. Так закрывает правило файлы с параметрами или нет?
Редакция ZrokЗвёздочка * заменяет любую последовательность символов, а доллар $ закрепляет конец адреса, и поведение правила легко истолковать по-разному. В спорных случаях удобнее не спорить, а проверить правило инструментом robots.txt в панели вебмастера — он покажет, попадает конкретный URL под запрет или нет.
Какие разделы закрывать на WordPress? И нужно ли запрещать индексировать файлы кэша?
Редакция ZrokКак ориентир закрывают служебные пути: административные разделы, внутренний поиск по сайту, личный кабинет и корзину. Технические и кэш-пути закрывают по той же логике. Но это не универсальный шаблон: набор путей подбирают под структуру конкретного сайта, а спорные правила проверяют инструментом.
На WordPress пробовал менять robots.txt несколькими плагинами, они отчитываются, что поменяли, а Яндекс показывает одну старую строку Disallow. Нашёл какой-то скрытый физический файл и не понимаю, как его править.
Редакция ZrokЭто типичный конфликт виртуального и физического файла: физический robots.txt в корне перекрывает то, что пишут плагины. Зайдите в корень по FTP и правьте файл прямо там, а правку несколькими плагинами отключите, чтобы остался один источник.
Нашёл ссылку на карту сайта, открываю — а там ошибка: Not Found. The requested URL /sitemap_index.xml was not found on this server. Почему карта не обнаружена?
Редакция ZrokАдрес из строки Sitemap должен реально существовать. Ошибка 404 означает, что по этому пути карты нет и краулер её не находит. Сначала убедитесь, что карта действительно отдаётся по своему адресу, и только потом ставьте на неё ссылку в robots.txt полным URL.
Короткие вопросы и ответы
ОльгаФайл нужно создавать вручную или WordPress сделает его сам?
Зависит от сайта. Если CMS отдаёт виртуальный robots.txt (как WordPress), отдельный файл создавать не нужно — его правят из админки через SEO-плагин. Если виртуального файла нет, создаёте обычный текстовый файл и загружаете в корень вручную.
ДенисАктуален ли сейчас файл robots.txt из примера?
Сами директивы User-agent, Disallow, Allow и Sitemap стабильны. Но имена ботов (product token) со временем меняются, поэтому строки под конкретных краулеров, особенно AI-ботов, сверяйте с актуальной документацией вендора.
АртёмПравда ли, что без robots.txt не работает контекстная реклама?
Нет. Рекламный робот и поисковый краулер — это разные роботы, и реклама работает независимо от наличия robots.txt. Файл управляет обходом сайта краулерами, а не показом объявлений.
КириллМожно ли просто скопировать чужой длинный robots.txt?
Копировать вслепую не стоит: пути вроде /administrator/ или /components/ относятся к конкретной CMS и на вашем сайте могут не существовать, а нужные вам разделы остаться открытыми. Возьмите базовый пример за основу и подставьте пути своей структуры.
- RFC 9309: Robots Exclusion ProtocolСтандарт файла.
- Google Search Central: Create and submit a robots.txt fileРазмещение и Sitemap.
- Яндекс Вебмастер: Директива Clean-paramСинтаксис Clean-param.
- OpenAI: Overview of OpenAI CrawlersТокены GPTBot и OAI-SearchBot.
- Anthropic: Does Anthropic crawl data from the webБлокировка ClaudeBot.
Источники проверены .