Как управлять доступом поисковых и AI-краулеров к сайту через robots.txt

robots.txt лежит в корне сайта по адресу /robots.txt и подсказывает поисковым и AI-краулерам, какие пути обходить можно, а какие нельзя. Добросовестные боты эту просьбу соблюдают, но техническим запретом файл не является.
Все разделы статьиОткрыть содержание
Короткий путеводитель по тому, что этот файл реально делает, кого он останавливает, а кого нет, и с чего начать именно вам.
Создано · Обновлено
Что такое robots.txt и как его читают краулеры
Начнём с самого файла, ведь весь разговор про доступ крутится вокруг него.
robots.txt это обычный текстовый файл. Он лежит в корне сайта по адресу /robots.txt, строго в нижнем регистре, и доступен любому краулеру, который к нему обратится.
«The rules MUST be accessible in a file named "/robots.txt" (all lowercase) in the top-level path of the service.»RFC 9309, Robots Exclusion Protocol, раздел 2 · проверено 20.10.2026
Что это значит для сайта. Файл должен лежать именно по адресу /robots.txt в корне и в нижнем регистре, иначе краулер его просто не найдёт.
Ничего магического внутри нет.
Краулер работает по порядку. Прежде чем ходить по вашим страницам, он запрашивает /robots.txt, читает строки User-agent с правилами доступа к путям и только потом решает, что обходить.
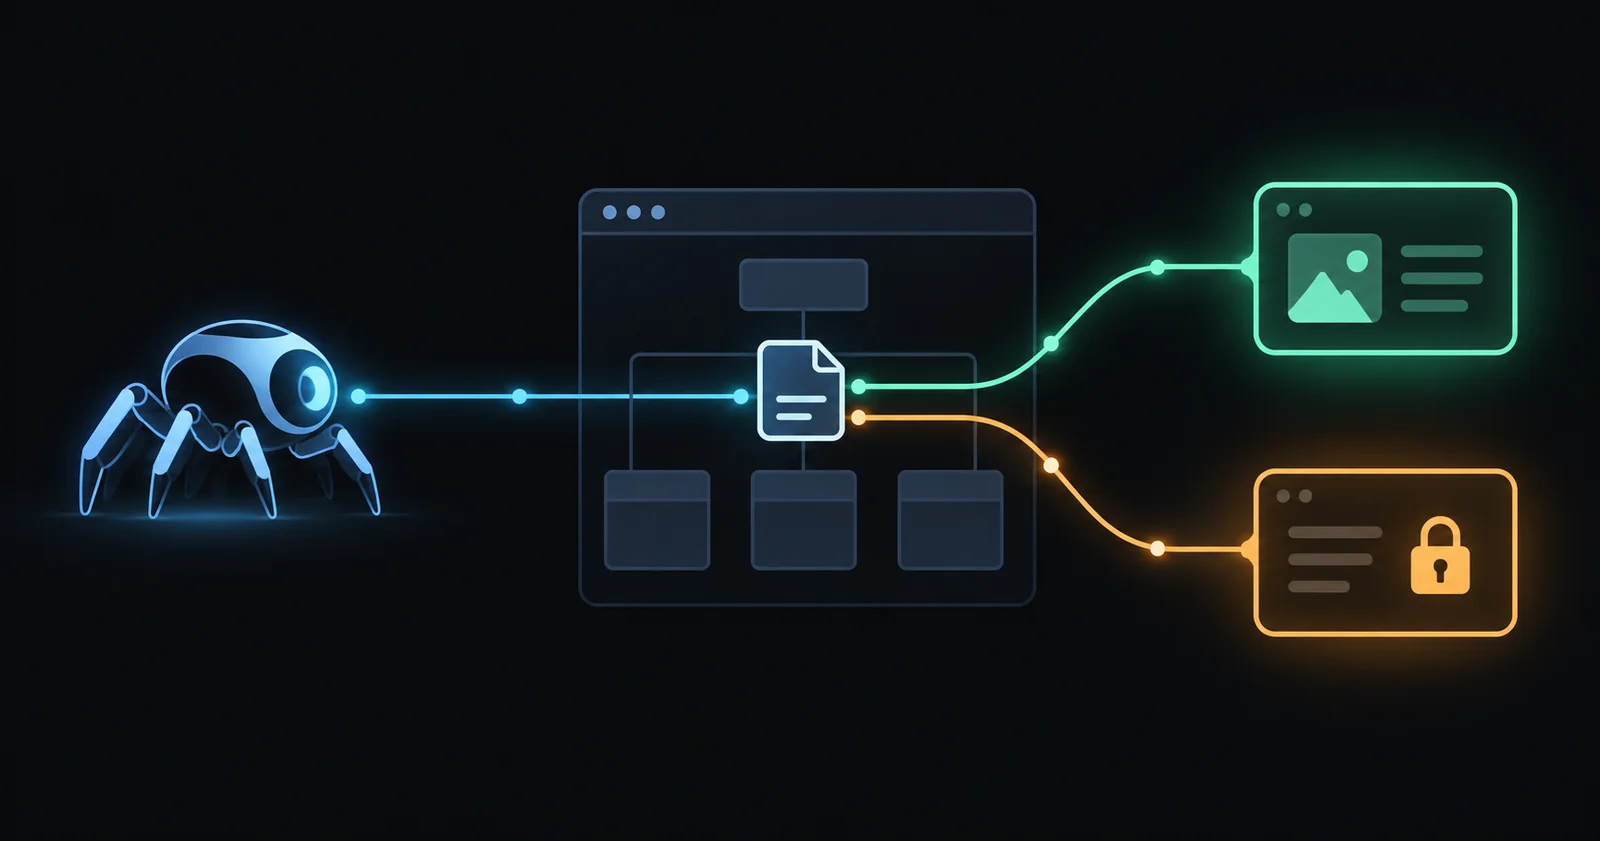
Одни разделы в ответе открыты, другие закрыты. Это и есть карта доступа, по которой бот строит обход.
User-agent: *
Disallow: /tmp/
Allow: /

User-agent: GPTBot
Disallow: /drafts/Сначала краулер спрашивает, потом идёт.
В одном файле можно обращаться к разным ботам сразу. Каждому адресату отводится свой блок User-agent со своими правилами, поэтому обычные поисковые краулеры и AI-краулеры обслуживаются одним и тем же файлом.
И вот ключевое свойство этого файла.
Это правила обхода, то есть доступа к URI, которые соблюдающих ботов просят выполнять. Жёстким техническим барьером robots.txt не работает.
Поэтому файл действует только на тех, кто решил его соблюдать. Для остальных понадобится другой уровень защиты, и держать это в голове стоит с самого начала, чтобы не спутать просьбу с гарантией.
Раз файл только просит, встаёт вопрос, кто его вообще слушается.
Кто из поисковых и AI-ботов подчиняется robots.txt, а кто может его игнорировать
robots.txt остаётся просьбой. Разберёмся, кто её реально учитывает.
Добросовестные поисковые и AI-боты правила соблюдают. Часть ботов их игнорирует, особенно те, кому незачем представляться честно.
Просьба, а не замок.
У крупных вендоров есть свои токены user-agent, которые как раз и пишут в robots.txt.
У OpenAI таких токена три. GPTBot собирает данные для обучения моделей, OAI-SearchBot отвечает за поиск по сайтам внутри ChatGPT, а ChatGPT-User работает по запросу пользователя. У проекта Common Crawl это CCBot. Токены и назначение я сверяю с текущей документацией вендора.
| Краулер | Токен user-agent | Назначение | Управляется через robots.txt |
|---|---|---|---|
| OpenAI GPTBot | GPTBot | Сбор данных для обучения моделей | Да |
| OpenAI OAI-SearchBot | OAI-SearchBot | Поиск по сайтам в ChatGPT | Да |
| OpenAI ChatGPT-User | ChatGPT-User | Действия по запросу пользователя | Да |
| Common Crawl | CCBot | Открытый сбор данных веба | Да |
Токены и назначение сверяйте с текущей документацией вендора. В строках проверки встречаются также ClaudeBot и Google-Extended. Их назначение уточняйте по документации, а не по памяти.
Всеми этими ботами управляет тот же файл, что и обычными поисковыми краулерами. Отдельная галочка для ИИ не нужна, достаточно отдельного блока User-agent.
А почему эта тема вообще стала громкой?
Внимание к файлу выросло не на пустом месте. Доля автоматического трафика увеличилась, а AI-скраперы заметно нагружают инфраструктуру сайтов, и владельцы захотели этим управлять осознанно.
Как увидеть ботов в своём трафике
Сначала разберёмся, как этих ботов вообще заметить у себя.
Обычная веб-аналитика их почти не показывает. Краулеры не исполняют JavaScript, а счётчик срабатывает именно на нём. Зато серверные логи доступа фиксируют каждый визит, ведь в строке user-agent бот представляется сам.
203.0.113.10 - - [20/Oct/2026:09:14:02 +0000] "GET /guides/ HTTP/1.1" 200 5123
User-Agent: Mozilla/5.0 (compatible; GPTBot/1.4; +https://openai.com/gptbot)Логи знают больше, чем счётчик.
Раз ботов видно, перейдём к тому, что можно сделать с их доступом.
Что robots.txt может, а чего не может, и почему Disallow не запрещает индексацию
Теперь самое важное. Что файл реально умеет, а где он бессилен?
Проще всего представить шкалу доступа. На одном краю сайт полностью открыт для обхода, на другом полностью закрыт для конкретного бота, а посередине остаются любые промежуточные варианты.
- Пустой
Disallowу общей группыUser-agentсо звёздочкой оставляет сайт полностью открытым для обхода. - Директива
Disallowсо слешем полностью закрывает сайт для указанного бота. - Можно закрывать отдельные директории для отдельных ботов, и это вся середина шкалы между открытым и закрытым.
User-agent: *
Disallow:

User-agent: CCBot
Disallow: /А вот дальше начинается самое частое заблуждение.
Закрыл в robots.txt, значит, страницы нет в поиске? Нет.
Закрытие в Disallow запрещает обход, но не исключает страницу из индекса Google. Закрытый URL всё равно может быть найден и проиндексирован, если на него ссылаются с других сайтов.
«A page that's disallowed in robots.txt can still be indexed if linked to from other sites.»Google Search Central, Introduction to robots.txt, раздел об ограничениях · проверено 20.10.2026
Что это значит для сайта. Чтобы убрать страницу из выдачи, используйте noindex или закрытие доступа. Одного Disallow для этого недостаточно.
Получается парадокс. Обход закрыт, а сам адрес висит в выдаче, иногда с невнятным сниппетом, потому что содержимое Google прочитать не смог.
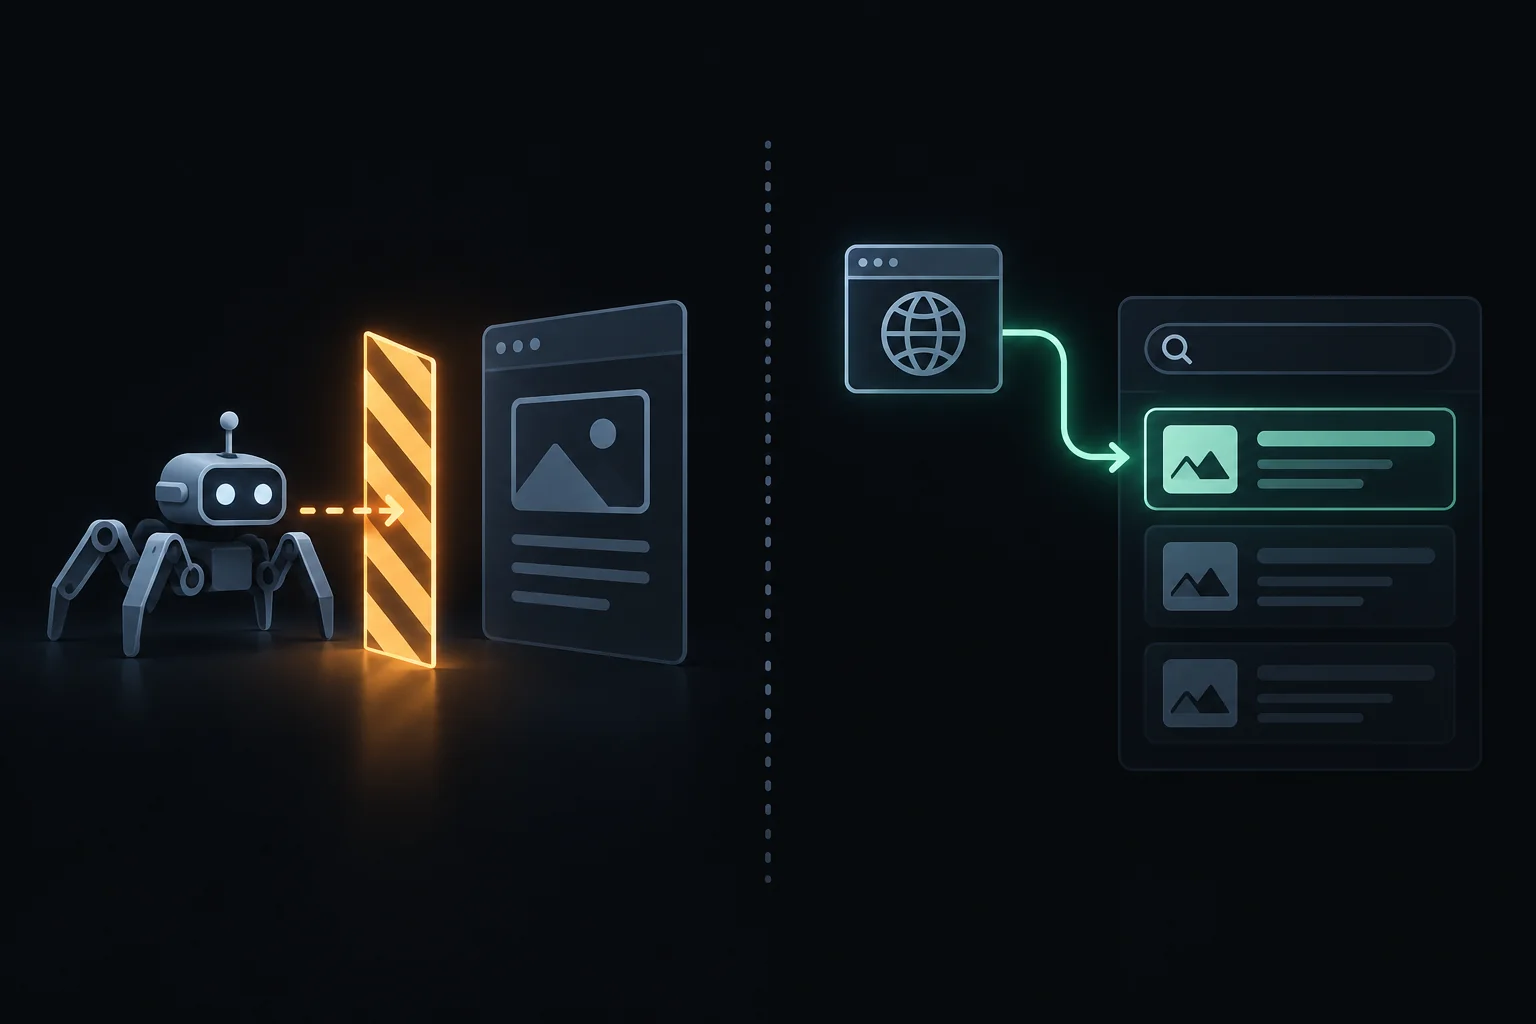
Закрытый обход не стирает адрес из поиска. Он всё ещё может всплыть в выдаче по внешней ссылке.
Обход и индекс живут на разных уровнях.
Чтобы убрать страницу из выдачи, нужен noindex или закрытие доступа, а не строка Disallow.
noindex просит поисковик убрать страницу из результатов. Закрытие доступа, то есть пароль или ограничение на уровне сервера, вообще не пускает к ней. Для задачи убрать страницу из поиска оба способа надёжнее строки в robots.txt, потому что работают там, где Disallow не властен.
Почему блокировка AI-ботов не роняет позиции в поиске
И ещё один частый страх.
Заблокирую AI-ботов и выпаду из Google?
Обычный поиск Google не относится к AI-ботам. Поэтому блокировка AI-краулеров сама по себе не равна выпадению из поисковой выдачи.
Пуская или не пуская краулеров, вы отдельно решаете про поисковую видимость и отдельно про обучение моделей на вашем контенте. Это две разные цели.
Эти две цели часто смешивают в одно правило, и это ошибка. Владелец закрывает всех ботов на всякий случай и заодно отрезает поисковик или полезный AI-поиск. Сначала решите, кого и зачем вы не пускаете.
Решайте по цели, а не по привычке закрывать всё подряд.
Прежде чем что-то менять, стоит посмотреть, что настроено сейчас.
Где посмотреть и как быстро проверить robots.txt
Посмотреть свой файл можно за минуту.
Откройте в браузере site.ru/robots.txt и найдите строки с GPTBot, ClaudeBot, Google-Extended и OAI-SearchBot. Если рядом с нужным ботом стоит Disallow, значит, этот краулер вы закрыли.
Буквально один адрес в адресной строке.
Чтобы проверить конкретный URL под конкретного бота, есть удобные инструменты. Это тестер robots.txt в Google Search Console, Bing Webmaster Tools или внешний валидатор.
Важная деталь. Результат для одного user-agent ничего не говорит про другого. Проверять стоит под каждого нужного бота отдельно, по его токену.
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /Но бывает хитрее.
Часто блокировка появляется не руками владельца. Её приносят шаблоны, старые конфигурации и пресеты платформ. У Cloudflare, например, есть функция управления AI-трафиком через robots.txt, которая может быть включена по умолчанию и дописывать файл за вас, сигнализируя, что контент не стоит использовать для обучения ИИ.
Здесь важно не путать два механизма. Управление ботами на уровне сервиса, то есть галочка в панели Cloudflare, и сам файл robots.txt работают по-разному, и одно не редактирует другое автоматически.
Не смешивайте эти два уровня.
Когда нужных ботов закрыли без вас
Понять, что полезных краулеров прикрыли случайно, можно по симптому. AI-ботов в логах стало меньше или они вовсе пропали, хотя сами вы правил не трогали.
Разборы типичных ситуаций
Разбор ситуации
Пресет Cloudflare закрыл нужных ботов
При аудите сайта клиента выяснилось, что GPTBot и ClaudeBot закрыты. Специально их никто не блокировал. Сработал пресет Cloudflare, который так и не пересмотрели.
Редакция ZrokКлассический случай непреднамеренной блокировки. Начните с просмотра site.ru/robots.txt и настроек управления ботами в панели платформы. Если блок не нужен, снимите его и перепроверьте доступ под каждого бота отдельно через тестер.
Разбор ситуации
Хостинг посоветовал закрыть лишних ботов
Хостинг-провайдер порекомендовал через Cloudflare блокировать неправильных ботов. Совет чуть не закрыл нужных краулеров, но их заметили вовремя и откатили.
Редакция ZrokОбщий совет блокировать ботов опасен тем, что под раздачу попадают и полезные краулеры. Прежде чем закрывать, решите, кого именно вы не пускаете и зачем. И помните, что галочка в панели сервиса и сам файл robots.txt это разные механизмы, они не правят друг друга.
После любых правок перепроверьте файл под каждого нужного бота, и через site.ru/robots.txt, и тестером.
Рядом с robots.txt всё чаще поминают ещё один файл.
Зачем говорят про llms.txt и чем он отличается от robots.txt
Про llms.txt сейчас много разговоров, поэтому коротко по сути.
llms.txt это предложенный формат, то есть файл /llms.txt, который работает как карта самого ценного контента для языковых моделей. По логике он продолжает robots.txt и sitemap, но ориентирован именно на LLM.
robots.txt он при этом не заменяет.
robots.txt регулирует обход и определяет, какие пути можно смотреть. llms.txt предлагает модели ориентир по ценному контенту, где собраны главные страницы и короткие описания. Это дополнение, которое работает на другом уровне и для другой задачи.
Статус у формата пока скромный. Это предложение, а не официальный стандарт; крупные вендоры официально его не поддерживают, а использовать карту или нет решает сам бот.
Поскольку это всё ещё предложение, поддержка зависит от конкретного бота. Закладываться на llms.txt как на гарантию сейчас рано, и для большинства небольших сайтов он не в приоритете.
Нужен не всем и не прямо сейчас.
Теперь выберите свою ситуацию.
С чего начать в вашей ситуации
По каждой типичной ситуации даю короткий честный ответ и показываю, куда двигаться дальше.
Ещё нет robots.txt. Поймите, что файл управляет обходом, заведите его в корне сайта и опишите, кого и куда пускать. Пошаговый синтаксис директив ждёт в отдельном детальном разборе хаба.
Нужно закрыть раздел или весь сайт. robots.txt попросит соблюдающих ботов не обходить указанные пути. Для гарантии этого мало, понадобится уровень сервера и/или noindex.
Файл есть, но непонятно, не блокирует ли он нужных ботов. Откройте site.ru/robots.txt, прогоните URL через тестер или валидатор и учтите пресеты Cloudflare.
Страница закрыта, но всё ещё в поиске. Disallow запрещает обход, а индексацию не трогает. Нужен noindex или закрытие доступа.
Услышали про llms.txt. Это предложенный формат-карта для языковых моделей, дополнение к robots.txt. Вендоры официально пока не поддерживают, так что спешить незачем.
Каждая из этих веток ведёт в свой детальный материал хаба, будь то составление файла, сценарии закрытия от индексации, разбор конкретных AI-ботов или проверка их подлинности. Здесь я намеренно не дублирую их содержание, а показываю развилку, чтобы вы не читали всё подряд.
Начните со своей строки.
Найдите ситуацию, которая описывает ваш случай, и переходите к подробному разбору именно по ней.
Вопросы и ответы
ОльгаКак отличить полезных ботов от лишних в трафике?
Опирайтесь на строку user-agent в серверных логах. Добросовестные боты честно представляются и указывают ссылку на свою документацию. Детальная проверка подлинности, то есть сверка IP с опубликованными вендором диапазонами, это отдельный разбор в хабе.
ПавелМожно ли вообще полностью остановить скрейпинг?
Полностью остановить не выйдет. robots.txt останавливает только тех, кто его соблюдает. Реальная цель это снизить объём и усложнить доступ, сочетая соблюдаемые правила для добросовестных ботов с мерами на уровне сервиса для остальных.
ТимурИмеет ли значение язык llms.txt для мультиязычного сайта?
Предложение llms.txt этот момент прямо не регламентирует, и единого правила у вендоров пока нет. Разумно делать карту на основном языке вашего контента, но гарантий, как именно бот её прочитает, сейчас никто не даёт.
- RFC 9309, Robots Exclusion ProtocolСтандарт описывает расположение /robots.txt и смысл правил Allow и Disallow как правил обхода.
- Google Search Central, Introduction to robots.txtGoogle напоминает, что страница, закрытая в robots.txt, может быть проиндексирована по внешним ссылкам.
- Overview of OpenAI CrawlersТокены GPTBot, OAI-SearchBot, ChatGPT-User и их назначение.
- CCBot от Common CrawlТокен CCBot и управление его обходом через robots.txt.
- Предложение /llms.txt на llmstxt.orgСтатус формата llms.txt как предложения.
Схемы в материале это редакционные иллюстрации команды Zrok.
Источники проверены .